DeepSeek avis : une alternative crédible pour le code, les gros volumes et les budgets API
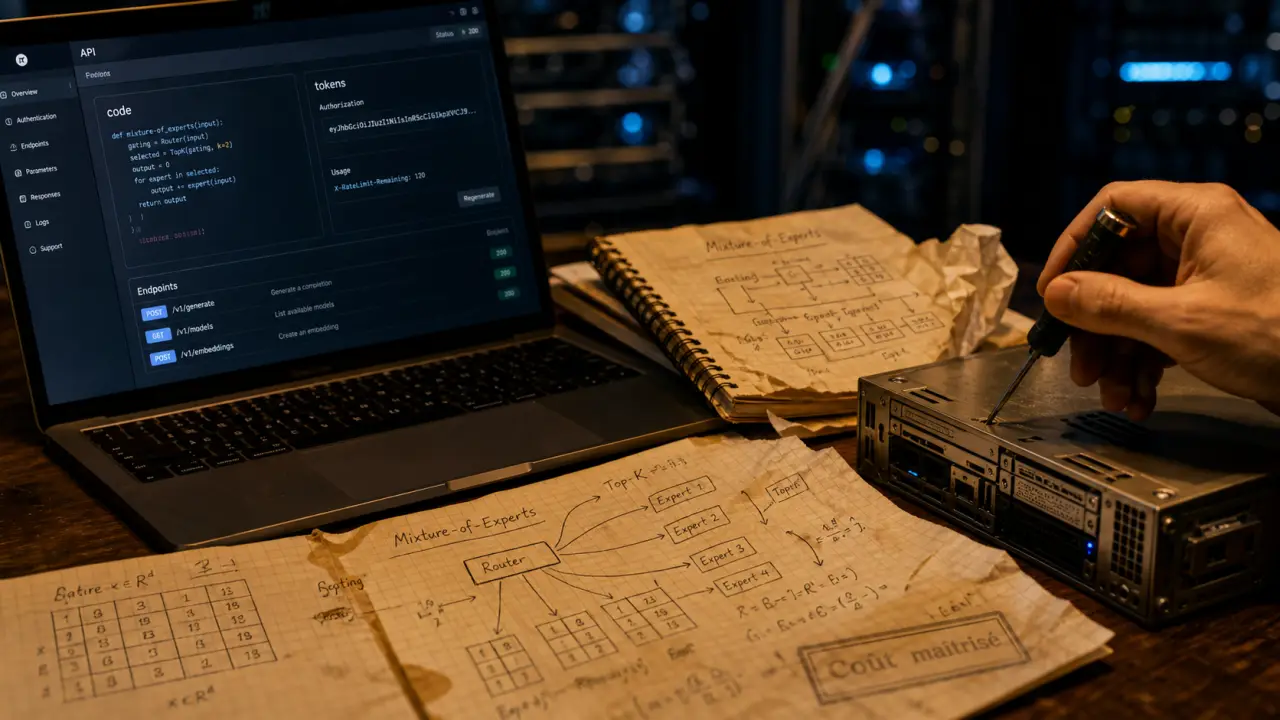
DeepSeek attire l’attention parce qu’il promet une IA performante, plus accessible et plus ouverte que les grands modèles propriétaires. Pour un utilisateur qui hésite entre DeepSeek, ChatGPT, Claude ou l’API d’OpenAI, la vraie question n’est pas seulement de savoir si l’outil fonctionne, mais dans quel contexte il devient le meilleur choix. L’avis le plus juste est nuancé : DeepSeek peut être excellent pour le code, le raisonnement, les gros volumes et les coûts d’API, mais il demande plus de vigilance sur les données, la conformité et l’intégration professionnelle.
Ce que DeepSeek apporte vraiment face aux IA les plus connues
DeepSeek est une famille de modèles d’intelligence artificielle générative conçue pour traiter du texte, raisonner, écrire du code, analyser des documents et répondre à des requêtes complexes. Son nom revient souvent dans les comparaisons avec ChatGPT, OpenAI et Claude, car il combine trois arguments forts : un coût attractif, une approche open source ou open weight selon les modèles, et de bonnes performances sur des tâches techniques.
Guide officiel pour intégrer l’API DeepSeek · Découvrez comment effectuer votre premier appel API et connecter les modèles DeepSeek à vos applications grâce à cette documentation technique complète.
L’un de ses marqueurs techniques est l’architecture Mixture-of-Experts, ou mélange d’experts. L’idée est simple : ne pas mobiliser tout le modèle à chaque requête, mais seulement certains experts spécialisés selon la tâche. Dans les versions évoquées, on parle de 256 réseaux spécialisés, avec des modèles de grande taille comme 671 Mds de paramètres dont une fraction seulement est active à l’inférence. Cette logique aide à réduire les coûts tout en maintenant un niveau de réponse solide.
Pourquoi autant d’attention autour du coût ?
DeepSeek a beaucoup fait parler de lui parce que son développement a été présenté avec des montants très inférieurs à ceux des géants américains : 5,6 millions de dollars, parfois 6 millions de dollars, là où les concurrents sont associés à des budgets pouvant atteindre 100 millions de dollars. Cette différence alimente l’idée d’une rupture économique, renforcée par des comparaisons évoquant un modèle 20 à 40 fois moins cher selon les usages.
Pour un particulier, cela signifie surtout une alternative crédible à tester. Pour une entreprise, l’enjeu est plus concret. Si une application consomme 15 millions de tokens par jour, le prix de l’API devient vite un poste majeur du coût total de possession. Un modèle moins cher peut alors changer la faisabilité économique d’un chatbot interne, d’un outil de classification documentaire ou d’un assistant de développement.
Notre avis sur les performances : très solide, mais à tester sur vos propres tâches
Le point fort le plus souvent associé à DeepSeek est sa performance sur les tâches de code et de raisonnement. Les benchmarks cités autour de HumanEval indiquent jusqu’à 90 % sur certains tests de programmation, et plus de 80 % sur SWE-bench dans des comparaisons orientées développement logiciel. Ces chiffres ne garantissent pas un résultat parfait en production, mais ils expliquent pourquoi les développeurs, agences et équipes data le regardent de près.
Code, raisonnement et longs documents
DeepSeek est particulièrement intéressant lorsqu’il faut expliquer une erreur, générer une fonction, refactoriser un script, comparer deux approches techniques ou analyser une base documentaire volumineuse. Les fenêtres de contexte annoncées, comme 128K tokens et jusqu’à 1 million de tokens selon certaines versions mentionnées, sont un vrai avantage pour travailler sur des contrats longs, des spécifications produit, des tickets de support ou des corpus internes.
Il faut toutefois rester prudent avec les très grands contextes. Comme d’autres modèles, DeepSeek peut perdre de la précision sur des informations placées au milieu d’un document très long, un phénomène souvent appelé lost in the middle. La bonne pratique consiste à structurer les entrées : sommaire, sections numérotées, consignes explicites et demandes de citations internes au document. Un modèle puissant ne remplace pas une préparation claire du prompt.
Un bon test IA commence par vos cas réels
Un test pertinent de DeepSeek part de vos cas d’usage réels. Au lieu de lui demander une réponse générale sur un sujet connu, donnez-lui un ancien ticket client mal classé, un morceau de code qui échoue, une clause juridique ambiguë ou une extraction de tableau imparfaite. Vous verrez alors si le modèle capte les détails utiles, s’il respecte vos consignes et s’il restitue une réponse exploitable. C’est souvent là que la différence entre deux IA devient visible.
DeepSeek, ChatGPT ou Claude : le bon choix dépend du critère prioritaire
Comparer DeepSeek à ChatGPT ou Claude n’a de sens que si l’on précise le terrain. ChatGPT reste très fort en polyvalence, en interface utilisateur, en écosystème et en adoption grand public. Claude est souvent apprécié pour la qualité rédactionnelle, la lecture de documents et le ton plus posé. DeepSeek se distingue plutôt par son rapport performance-prix, son intérêt pour le code et la possibilité d’envisager un hébergement plus contrôlé.
| Critère | DeepSeek | ChatGPT / OpenAI | Claude |
|---|---|---|---|
| Rapport qualité-prix | Très compétitif, surtout via API et gros volumes | Solide, mais souvent plus coûteux selon l’usage | Variable selon les besoins et les offres |
| Code et raisonnement | Très bon niveau, benchmarks favorables | Très polyvalent, excellent écosystème | Bon, avec une approche souvent prudente |
| Longs documents | Intéressant avec 128K tokens ou plus selon la version | Très dépendant du modèle utilisé | Réputé confortable pour l’analyse de texte |
| Open source / open weight | Argument fort selon les modèles | Modèles principalement propriétaires | Modèles propriétaires |
| Conformité et données | À cadrer fortement, surtout via API | Offres entreprise plus structurées | Offres entreprise orientées sécurité |
En pratique, DeepSeek n’est pas forcément “meilleur” que ChatGPT dans l’absolu. Il peut être meilleur pour réduire une facture API, automatiser du traitement technique ou garder plus de contrôle sur l’infrastructure. Il peut être moins adapté si vous cherchez l’expérience la plus simple, des garanties contractuelles immédiatement lisibles ou une intégration déjà validée par vos équipes conformité.
Pour qui DeepSeek est vraiment pertinent
Développeurs, freelances et équipes produit
Pour un développeur solo ou une petite équipe, DeepSeek peut être un excellent copilote de travail : génération de snippets, revue de code, explication de bugs, écriture de tests, transformation de scripts ou documentation technique. L’intérêt augmente si vous utilisez un client agent IA, par exemple dans un environnement de type OpenCode, où le modèle peut accompagner des tâches de développement plus longues.
Les chefs de produit peuvent aussi l’utiliser pour résumer des retours clients, comparer des user stories, transformer des notes en spécifications ou analyser des tickets. Dans ce cas, la qualité du résultat dépend surtout de la structure des données. DeepSeek est puissant, mais il ne devine pas les priorités produit si elles ne sont pas clairement indiquées.
Entreprises avec gros volumes et contraintes budgétaires
DeepSeek devient particulièrement intéressant lorsqu’une entreprise veut industrialiser des usages IA sans faire exploser son budget : classification de documents, réponses internes, extraction d’informations, analyse de contrats, préqualification de demandes, enrichissement de bases de connaissances. Sur ces usages répétitifs, le différentiel de coût peut compter davantage que de petites variations de style dans les réponses.
En revanche, les secteurs régulés doivent avancer par étapes. Une direction juridique, une banque, une assurance, une entreprise de santé ou une organisation publique ne devrait pas envoyer des données sensibles dans une API sans analyse préalable. Le bon réflexe consiste à distinguer les cas d’usage non sensibles, les données pseudonymisées et les scénarios qui nécessitent un hébergement maîtrisé.
Données, conformité et limites : le point à ne pas sous-estimer
Le principal frein à l’adoption professionnelle de DeepSeek n’est pas toujours la performance, mais la gouvernance. L’utilisation via API peut poser des questions de transit des données, notamment lorsque des flux sont susceptibles de sortir du périmètre habituel de l’entreprise. Dans un cadre RGPD, il faut regarder où les données transitent, qui les traite, quelles garanties contractuelles existent et comment sont gérés les journaux, la conservation et les droits d’accès.
Auto-hébergement : une piste sérieuse, pas une baguette magique
L’ouverture des modèles rend l’auto-hébergement attractif. En théorie, héberger DeepSeek sur une infrastructure contrôlée permet de réduire la dépendance à un prestataire externe et d’améliorer la souveraineté des données. C’est un avantage fort face aux modèles propriétaires, surtout pour les organisations qui veulent auditer, paramétrer ou isoler leurs traitements.
Mais l’auto-hébergement a un coût caché : infrastructure GPU, supervision, sécurité, mises à jour, optimisation de l’inférence, compétences MLOps et responsabilité interne. Les mentions autour de plus de 16 000 puces Nvidia ou de 2000 puces Nvidia dans certaines discussions rappellent que l’IA performante repose aussi sur du matériel lourd. Même si vous n’avez pas besoin d’une telle échelle, faire tourner un modèle efficacement n’est pas neutre.
Verdict pratique
Mon avis sur DeepSeek est favorable si votre priorité est le rapport qualité-prix, le code, le raisonnement ou le traitement de gros volumes. C’est une alternative sérieuse, surtout pour les profils techniques et les entreprises capables de tester, mesurer et encadrer leurs usages. En revanche, pour des données sensibles, des besoins de conformité stricte ou une adoption grand public sans paramétrage, ChatGPT, Claude ou une offre entreprise plus cadrée peuvent rester plus rassurants.
La meilleure décision consiste à lancer un test court sur trois scénarios : une tâche de code, une tâche documentaire et une tâche métier réelle. Comparez la précision, le coût, le temps gagné, les erreurs et les contraintes de données. Si DeepSeek réussit ces tests avec un coût nettement inférieur, il mérite sa place dans votre stack IA. Sinon, il restera un excellent modèle à surveiller plutôt qu’un choix par défaut.
- Office 365 cloud computing : choisissez entre suite bureautique, services cloud et PC Cloud - 18 septembre 2026
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Midjourney essai gratuit : 25 images, accès variable et alternatives sans payer
 Logiciel paie automatisé : gagner du temps sur les variables, les contrôles et l’archivage
 CRM avec intelligence artificielle : automatiser, scorer, prévoir et mesurer le ROI
 Intelligence artificielle en banque : usages concrets, gains mesurables et risques à maîtriser