DeepSeek ou Qwen : quel modèle choisir pour coder, raisonner et réduire le coût API ?
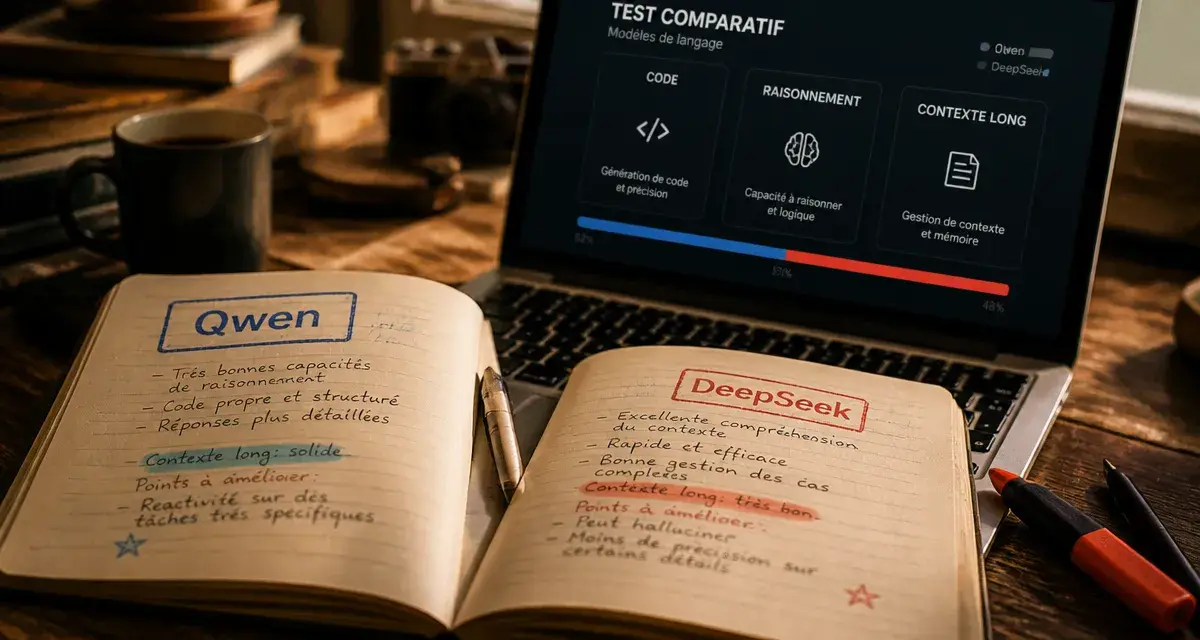
Comparer DeepSeek et Qwen n’a de sens que si l’on part de l’usage réel : générer du code, raisonner sur un problème complexe, analyser de longs documents, réduire les coûts API ou déployer un modèle dans un environnement maîtrisé. Les deux familles de modèles sont solides, souvent disponibles en open-weight, mais elles ne brillent pas toujours au même endroit.
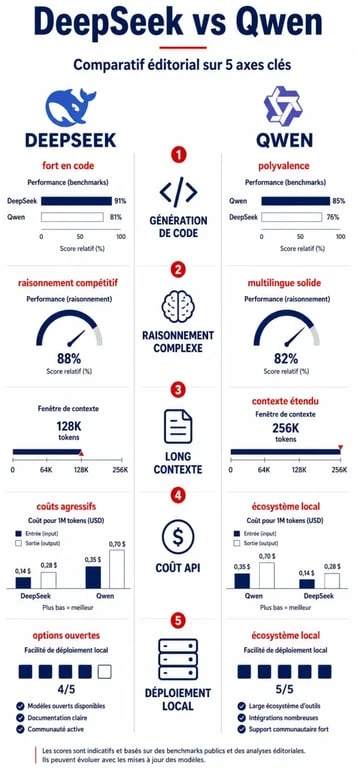
En pratique, Qwen est souvent le choix le plus confortable pour des workflows polyvalents, rapides et orientés productivité, tandis que DeepSeek se distingue quand le raisonnement profond, la résolution étape par étape et l’optimisation coût-performance deviennent prioritaires. Le bon choix dépend donc moins d’un « meilleur modèle » absolu que d’un arbitrage entre qualité de sortie, vitesse, contexte, budget et contraintes de production.
Verdict rapide selon le cas d’usage
Pour décider vite, il faut éviter de comparer seulement des scores de benchmark. Un modèle peut être excellent sur une épreuve standardisée et moins agréable à utiliser dans un dépôt réel, avec des dépendances, du code legacy, des règles métier et des contraintes de sécurité. Le tableau ci-dessous donne une lecture opérationnelle.
| Besoin principal | Avantage probable | Pourquoi |
|---|---|---|
| Génération de code lisible | Qwen | Sorties souvent structurées, claires et faciles à intégrer dans des tâches courantes. |
| Raisonnement complexe | DeepSeek | Bon comportement sur les tâches qui demandent une analyse progressive et une vérification logique. |
| Long contexte | Selon version | Certaines variantes annoncent 128K, d’autres montent jusqu’à 1M de contexte, ce qui change fortement les usages possibles. |
| Budget API serré | DeepSeek | Tarifs souvent agressifs, avec des repères observés autour de $0.15/M en entrée et $0.55/M en sortie selon les offres. |
| Déploiement local ou contrôlé | Qwen ou DeepSeek | Les deux écosystèmes proposent des modèles open-weight dans plusieurs tailles. |
| Prototype produit polyvalent | Qwen | Large gamme de tailles, y compris 0.6B, 1.7B, 4B, 8B, 14B, 32B et 235B selon les variantes. |
Quand choisir Qwen sans hésiter
Qwen est particulièrement pertinent si vous cherchez un assistant de développement généraliste, capable de produire des fonctions propres, de reformuler des spécifications, de manipuler des données ou d’aider à structurer une interface. Sa gamme de modèles est large, ce qui facilite l’ajustement entre puissance, latence et coût d’hébergement. Les variantes comme Qwen3-235B-A22B ou Qwen3-30B-A3B illustrent aussi une logique MoE, avec un nombre de paramètres actifs inférieur au total, par exemple 22B actifs pour certaines configurations.
Quand DeepSeek devient plus intéressant
DeepSeek prend l’avantage lorsque la tâche exige de tenir un raisonnement sur plusieurs étapes : diagnostic d’un bug non évident, choix d’algorithme, arbitrage d’architecture, planification ou résolution d’un problème ambigu. DeepSeek R1 est souvent associé à cet usage de reasoning, tandis que DeepSeek V3 est davantage mobilisé dans des comparaisons orientées performance et code. Si votre problème ressemble plus à une enquête qu’à une simple génération de texte, DeepSeek mérite un test prioritaire.
Code, debugging et maintenabilité : le critère qui change tout
Sur la génération de code, la question n’est pas seulement « est-ce que ça marche ? ». Un bon résultat doit être lisible, modulaire, testable et raisonnablement défensif. Dans les tests pratiques observés autour de ces modèles, les tâches reviennent souvent sur quatre familles : génération algorithmique, transformation de données, logique DOM et événements, validation d’entrée. Ce sont de bons terrains d’évaluation, car ils révèlent vite les faiblesses d’un modèle.
Qwen pour avancer vite sur du code courant
Qwen donne souvent de bons résultats lorsque la demande est bien cadrée : créer un composant, transformer un tableau d’objets, écrire une fonction utilitaire, proposer un refactoring ou documenter un module. Son style de réponse est généralement direct, avec une structure facile à reprendre. Pour une équipe produit qui veut accélérer les tâches répétitives sans lancer une analyse trop lourde à chaque prompt, c’est un avantage concret.
Il reste toutefois nécessaire de contrôler la robustesse : gestion des cas limites, validation d’entrée, messages d’erreur, complexité algorithmique. Une réponse élégante peut masquer une hypothèse fragile. Lorsque la performance compte, demandez explicitement la complexité attendue, par exemple O(n), et exigez un jeu de tests couvrant les cas vides, les doublons, les valeurs nulles et les entrées malformées.
DeepSeek pour déboguer et expliquer les décisions
DeepSeek est plus convaincant lorsque le code ne doit pas seulement être produit, mais justifié. Pour analyser une erreur de concurrence, comparer deux structures de données ou expliquer pourquoi une validation échoue dans un flux applicatif, il a tendance à dérouler un raisonnement plus complet. Cette profondeur peut coûter un peu plus de temps en inférence, mais elle devient précieuse pour les bugs difficiles et les revues de conception.
Un bon test consiste à lui fournir un extrait imparfait, puis à demander trois niveaux de réponse : diagnostic, correction minimale, puis refactoring maintenable. S’il identifie les effets de bord, les invariants et les risques de régression, vous avez un meilleur signal qu’avec un simple benchmark de génération.
Raisonnement, contexte long et architecture : ce que les benchmarks ne disent pas toujours
Les benchmarks donnent des repères utiles, mais ils ne remplacent pas un essai sur vos propres données. Certains chiffres circulent, comme 60.6% contre 59.0% sur des comparaisons ciblées, ou 92.4% contre 90.1% sur d’autres mesures. Ces écarts peuvent être significatifs, mais ils ne disent pas toujours si le modèle respectera votre format JSON, comprendra votre documentation interne ou gardera la cohérence sur un dossier de 80 pages.
Le long contexte n’est pas juste une grande fenêtre
Une fenêtre de contexte de 128K ou de 1M tokens n’a de valeur que si le modèle sait retrouver l’information pertinente, éviter les contradictions et ne pas diluer l’instruction principale. Pour de l’analyse documentaire, du RAG, des contrats, des tickets support ou des bases de connaissance, testez la précision de récupération, pas seulement la capacité à ingérer beaucoup de texte.
Concrètement, placez une information critique au début, au milieu et à la fin d’un long document, puis demandez une synthèse avec citations de passages. Vous verrez rapidement si le modèle lit vraiment le contexte ou s’il produit une réponse plausible mais approximative. Sur ce terrain, le choix entre Qwen et DeepSeek dépend fortement de la version exacte et de la configuration d’inférence.
L’architecture MoE change le coût réel
Les modèles Mixture-of-Experts ne mobilisent qu’une partie de leurs paramètres à chaque génération. C’est ce qui explique des configurations comme 235B avec 22B actifs, ou 30B avec 3B actifs. Pour l’utilisateur, l’intérêt est simple : obtenir une capacité élevée sans payer systématiquement le coût d’un modèle dense équivalent. Mais l’efficacité dépend aussi du routage, du KV-cache, de la longueur de sortie et de votre infrastructure.
Il faut penser le choix d’un modèle comme un assemblage précis. Un LLM puissant mal intégré peut produire des formats instables, des prompts trop longs et des coûts qui montent vite. À l’inverse, un modèle un peu plus petit, bien cadré avec des instructions courtes, des exemples précis, un schéma de sortie strict et une étape de contrôle, peut donner un résultat plus fiable qu’un modèle supérieur utilisé sans garde-fou.
Prix, licence et déploiement : le vrai coût ne se limite pas au token
Le coût d’un modèle se calcule rarement sur le seul prix affiché. Il faut additionner les tokens d’entrée, les tokens de sortie, le cache éventuel, les appels répétés, la latence, la supervision humaine, l’hébergement et les contraintes juridiques. Dans certaines offres, des repères comme $0.15/M en entrée, $0.55/M en sortie ou $2.50/M pour des usages plus exigeants donnent une base de comparaison, mais votre facture dépendra surtout du volume et de la longueur moyenne des conversations.
API ou open-weight : deux logiques différentes
L’API est le meilleur choix pour tester vite, limiter la maintenance et accéder rapidement à de bonnes performances. Elle convient aux prototypes, assistants internes et produits où le time-to-market prime. L’open-weight devient plus intéressant si vous avez des contraintes de confidentialité, de coût à grande échelle, de personnalisation ou de déploiement sur infrastructure maîtrisée.
Qwen et DeepSeek ont tous deux un intérêt dans cette seconde logique, car leurs écosystèmes proposent plusieurs tailles de modèles. Les petites variantes, comme 0.6B, 1.7B ou 4B côté Qwen selon les gammes, permettent des usages embarqués ou à faible coût. Les modèles plus grands, comme 32B, 235B ou 671B dans certaines familles, visent plutôt des charges plus ambitieuses, avec davantage d’exigences matérielles.
La licence doit être vérifiée avant la production
Avant tout usage commercial, vérifiez précisément la licence de la version choisie, pas seulement le nom de la famille. Certaines comparaisons opposent par exemple Apache 2.0 et MIT, deux licences permissives, mais les conditions peuvent varier selon le modèle, le dépôt, les poids, les services associés et les restrictions éventuelles. Pour une entreprise, ce point compte autant que le score de benchmark : il conditionne la redistribution, l’intégration produit et la conformité interne.
La méthode simple pour trancher entre DeepSeek et Qwen
Le meilleur arbitrage consiste à tester les deux modèles sur cinq prompts représentatifs de votre activité, pas sur des exemples génériques. Prenez un cas de génération, un cas de correction, un cas de raisonnement, un cas de long contexte et un cas de format strict. Notez ensuite chaque réponse sur des critères identiques : exactitude, lisibilité, temps de réponse, coût estimé, stabilité du format et facilité d’intégration.
- Choisissez Qwen si vous privilégiez la productivité quotidienne, la polyvalence, la génération de code propre et une gamme flexible de tailles de modèles.
- Choisissez DeepSeek si votre priorité est le raisonnement, l’analyse approfondie, le debugging complexe ou un excellent rapport coût-performance via API.
- Testez les deux si votre projet repose sur du long contexte, car la version exacte, la fenêtre disponible et la qualité de récupération changent le résultat.
- Ne décidez pas sur un seul benchmark : un écart de score ne remplace pas un test sur vos données, vos formats et vos contraintes métier.
En résumé, Qwen ressemble davantage à un assistant polyvalent et efficace pour construire vite, tandis que DeepSeek s’impose quand il faut creuser, raisonner et optimiser. Pour un projet sérieux, le bon réflexe n’est pas de chercher un vainqueur universel, mais de créer une mini-batterie de tests proche de votre production. C’est là que la différence entre un modèle impressionnant et un modèle réellement utile devient visible.
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
- Application productivité : 6 outils pour reprendre le contrôle de vos journées - 14 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Stratégie digitale WebGrowth Plus : croissance mesurable ou simple addition d’actions en silos ?
 De l’audit au ROI, le consultant en stratégie digitale évite les actions dispersées
 RNCP, CPF, niveau d’entrée : comment choisir une certification IA reconnue sur choisir-formation.com ?
 Master développement web : Bac+5, RNCP niveau 7 et spécialisations à vérifier avant de candidater