DeepSeek : performance, censure et puces, que cache vraiment ce modèle chinois ?
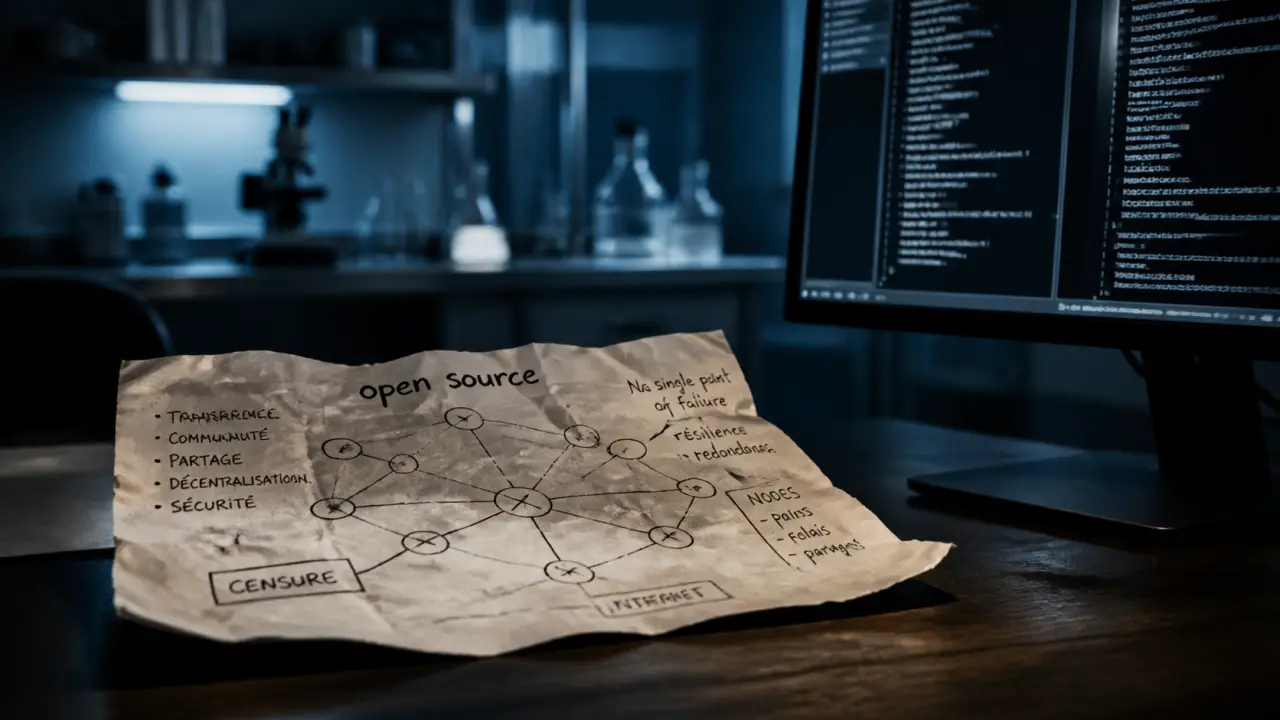
DeepSeek attire l’attention parce qu’un seul nom concentre plusieurs sujets : un modèle de langage chinois, une promesse de coût réduit, une diffusion open source et des questions sur la censure, le financement et les semi-conducteurs. Pour comprendre l’enjeu, il faut regarder la technique, le modèle économique, la politique et la manière dont le produit a été présenté.
DeepSeek, ce que l’outil est vraiment
DeepSeek désigne une famille de grands modèles de langage développés en Chine, avec plusieurs versions citées dans les analyses du secteur, comme V1, V2, R-1, V3 et certains dérivés. Comme d’autres LLM, il traite du texte, répond à des questions, aide à rédiger, résumer, coder ou raisonner sur des problèmes complexes. Son positionnement se distingue toutefois par une insistance forte sur l’open source, la performance et l’efficacité des ressources mobilisées.
Un modèle de langage, pas une simple interface de chat
Il serait réducteur de voir DeepSeek comme un simple site de conversation. L’interface n’est que la partie visible. Le sujet principal est le modèle lui-même, avec son architecture, ses données d’entraînement, sa capacité à être adapté et son coût d’exploitation. Dans les usages concrets, cela intéresse autant les curieux que les développeurs, les entreprises et les chercheurs qui veulent expérimenter sans dépendre entièrement d’une plateforme propriétaire. C’est aussi ce qui explique l’attention portée aux versions successives, car elles traduisent des progrès réels dans la manière de produire du texte et de raisonner sur certains problèmes.
Une logique open source qui change la donne
Le caractère open source de DeepSeek signifie que des tiers peuvent examiner, modifier ou entraîner certaines versions sur d’autres bases. Cela ouvre la voie à un usage en boucle locale, c’est-à-dire sans passer systématiquement par les serveurs du fournisseur initial. Pour une organisation sensible à la confidentialité ou à la maîtrise technique, cette possibilité est importante : elle permet de tester, d’ajuster et parfois de déployer un modèle avec plus d’autonomie. Elle rend aussi la comparaison plus simple, car le modèle peut être évalué hors de l’environnement de départ.
Mais l’open source ne règle pas tout. Il ne garantit ni l’absence de biais, ni la transparence complète sur les données utilisées, ni la neutralité des réponses. Il donne un accès technique plus large, mais il ne supprime pas les interrogations sur l’origine du modèle, les choix de filtrage et les dépendances matérielles. En pratique, un modèle peut être ouvert sur le plan du code ou des poids, tout en restant encadré par des règles d’usage, des limites d’hébergement ou des réglages spécifiques selon l’interface utilisée.
Pourquoi DeepSeek a provoqué un choc médiatique et boursier
La surprise vient d’un écart apparent : DeepSeek semble avoir atteint un niveau de performance élevé avec une structure réduite et des coûts présentés comme inférieurs à ceux des grands acteurs américains. Ce contraste a nourri une tempête médiatique et boursière, car il remet en cause l’idée selon laquelle seuls des budgets gigantesques, des équipes massives et les infrastructures les plus rares permettraient de produire une IA de premier plan.
Dépôt officiel DeepSeek : système de fichiers distribué pour l’IA · Découvrez le dépôt GitHub officiel de DeepSeek présentant un système de fichiers distribué haute performance pour les charges de travail d’entraînement et d’inférence IA.
Le récit du “faire beaucoup avec moins”
Plusieurs éléments alimentent ce récit : une équipe évoquée comme comptant moins de 200 personnes, un coût d’entraînement présenté à 5,5 millions d’euros pour certaines étapes, et une capacité à rivaliser avec des modèles propriétaires établis. Dans un marché où l’entraînement et l’inférence coûtent cher, cette promesse de frugalité a un effet puissant : elle suggère qu’un acteur plus léger peut perturber une industrie dominée par quelques plateformes. Le contraste est d’autant plus marquant que l’IA générative donne souvent l’image d’un secteur réservé aux géants capables d’absorber des dépenses très élevées.
Des chiffres qui méritent d’être lus avec prudence
La lecture critique consiste à ne pas isoler un chiffre de son environnement. Si un coût d’entraînement est mis en avant, il faut aussi se demander ce qu’il inclut réellement : données, essais échoués, infrastructures préexistantes, ingénierie, optimisation, accès aux puces, maintenance et déploiement. Les références à 10 000 puces H100 Nvidia, à deux superordinateurs ou à un investissement de 400 millions d’euros rappellent que la performance d’un modèle ne se résume pas à une facture finale spectaculaire. Autrement dit, un montant mis en avant peut éclairer une partie du projet, sans raconter à lui seul toute la chaîne de production.
| Point observé | Ce que cela suggère | Ce qu’il faut vérifier |
|---|---|---|
| Modèle open source | Diffusion rapide et adaptation possible | Niveau réel de transparence et conditions d’usage |
| Coût réduit annoncé | Pression sur les modèles propriétaires | Périmètre exact du calcul de coût |
| Usage en boucle locale | Plus grande autonomie technique | Compétences et infrastructure nécessaires |
| Filtrage de certaines requêtes | Contrôle des réponses sensibles | Impact sur la fiabilité selon les sujets |
Open source, censure : le paradoxe DeepSeek
DeepSeek illustre un paradoxe central de l’IA contemporaine : un modèle peut être techniquement ouvert tout en restant politiquement encadré. L’ouverture du code ou des poids ne signifie pas que l’expérience utilisateur, notamment via une interface en ligne, échappe au filtrage. Certaines requêtes peuvent être bloquées, contournées ou recevoir des réponses orientées sur des sujets sensibles.
La censure ne se voit pas toujours au premier échange
Le contrôle ne consiste pas seulement à refuser frontalement une question. Il peut prendre la forme d’une réponse vague, d’un déplacement du sujet, d’une formulation très prudente ou d’un silence sur certains noms et événements. Les exemples souvent discutés autour de figures comme Liu Xiaobo ou de thèmes liés au pouvoir chinois montrent que la censure algorithmique doit être analysée non seulement comme un bug, mais comme un choix de gouvernance de l’information. Dans ce cadre, la qualité du modèle ne dépend pas seulement de sa capacité à produire une réponse, mais aussi de sa manière de gérer les sujets interdits ou sensibles.
Le bon réflexe consiste à traiter DeepSeek comme une serrure à plusieurs points plutôt que comme une porte simplement ouverte ou fermée. L’open source peut déverrouiller l’accès au modèle, mais d’autres verrous subsistent : les données d’origine, les couches de filtrage, l’hébergement, la juridiction, les dépendances aux puces et les réglages imposés par l’interface. Pour un utilisateur, cette grille de lecture évite une erreur fréquente : confondre liberté d’installation, liberté de réponse et liberté d’interprétation. Ce sont trois niveaux différents, et chacun peut être contrôlé par un acteur différent.
Pourquoi cela compte pour les entreprises et les utilisateurs
Pour un usage courant, ces limites peuvent sembler secondaires si l’objectif est de rédiger un e-mail ou d’obtenir une aide au code. Elles deviennent cruciales dès que l’on traite des sujets politiques, juridiques, scientifiques ou stratégiques. Une entreprise qui envisage DeepSeek doit donc tester le modèle sur ses propres cas d’usage, comparer les réponses avec d’autres systèmes et documenter les écarts. L’enjeu n’est pas de décréter qu’un modèle est “bon” ou “mauvais”, mais de savoir dans quelles conditions il est fiable. Cette approche évite les conclusions trop rapides et donne une base concrète pour décider si l’outil convient à un usage interne.
Qui se cache derrière DeepSeek ? Origines et structure à regarder de près
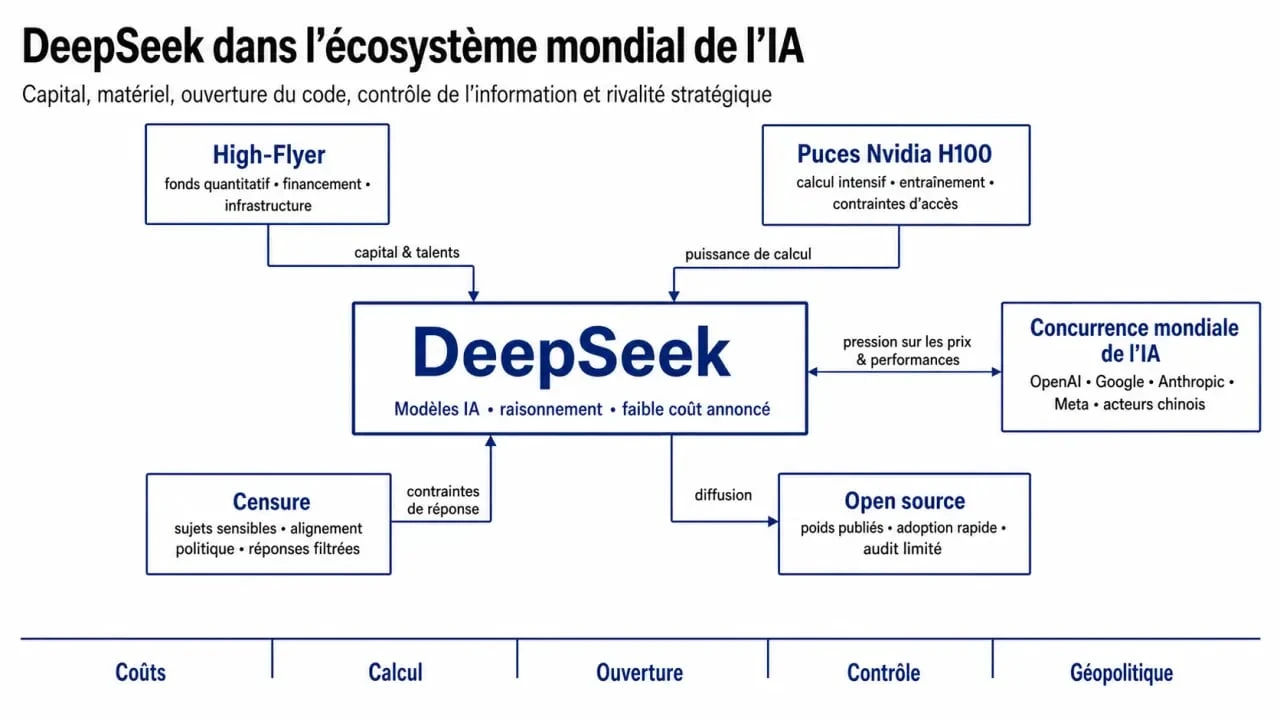
DeepSeek est généralement présenté comme lié à l’écosystème de High-Flyer, un fonds quantitatif chinois, lui-même associé à des structures comme Magic Cube, Huanfang Quant, Zhejiang Jiuzhang Asset Management Co. ou Ningbo Huanfang Quant Investment Management Partnership. Cette origine est importante : un fonds quantitatif manipule déjà des volumes massifs de données, des modèles mathématiques et des infrastructures de calcul. Le passage vers l’IA générative n’arrive donc pas dans le vide. Il s’inscrit dans une continuité de méthodes, de calcul et d’optimisation.
Liang Wenfeng et la continuité entre finance quantitative et IA
Le nom de Liang Wenfeng revient souvent dans les analyses consacrées à DeepSeek. Son parcours permet de comprendre la logique du projet : optimiser, modéliser, automatiser, puis appliquer ces compétences à un marché où la puissance de calcul et la qualité algorithmique deviennent des avantages compétitifs. Le récit de la petite équipe surgie de nulle part est donc à nuancer : DeepSeek peut être jeune, mais il s’inscrit dans une continuité technique et financière plus profonde. Cette continuité explique aussi pourquoi le projet a pu avancer vite, avec une organisation déjà habituée aux modèles intensifs en données.
Puces, restrictions et dépendances matérielles
La question des semi-conducteurs est incontournable. Les restrictions aux exportations, notamment autour des puces avancées, structurent la compétition entre la Chine, les États-Unis et les grands fournisseurs comme Nvidia, TSMC, Broadcom ou Qualcomm. Les mentions de H100, de H800 et d’achats importants avant certaines restrictions montrent que l’accès au matériel reste un facteur décisif. Même le meilleur algorithme doit tourner quelque part, sur des infrastructures coûteuses, rares et stratégiques. Sans cette base matérielle, la promesse de performance reste théorique.
Ce que DeepSeek révèle sur la concurrence mondiale de l’IA
Au-delà de son propre produit, DeepSeek révèle une transformation du marché : la performance ne suffit plus, le prix et la souveraineté deviennent des arguments centraux. En Chine, la concurrence entre acteurs comme Zhipu AI, Volcano Engine, Alibaba Cloud, Baidu, Tencent ou Huawei nourrit une guerre des prix qui peut accélérer l’adoption des modèles. Face à OpenAI, Anthropic, Mistral, Perplexity AI ou Llama, DeepSeek pousse aussi les acteurs occidentaux à justifier leurs coûts, leur fermeture et leur avance supposée. Le débat ne porte donc pas seulement sur la qualité d’un modèle, mais sur la structure du marché qui l’entoure.
Le phénomène invite également à interroger les biais cognitifs occidentaux. Une innovation chinoise est parfois perçue soit comme une menace exagérée, soit comme une réussite suspecte. Ces deux réflexes empêchent de penser clairement. La bonne approche consiste à séparer trois plans : la performance technique mesurable, le récit médiatique qui l’entoure, et l’usage stratégique qu’un État ou un marché peut en faire. À ce niveau, DeepSeek n’est pas seulement un produit, c’est aussi un objet de lecture pour comprendre comment l’IA se diffuse et se raconte.
DeepSeek n’est donc ni un miracle inexplicable, ni un simple coup de communication. C’est un signal : les modèles de langage deviennent plus diffusables, plus optimisés et plus politiques. Pour l’utilisateur, la conclusion pratique est simple : tester l’outil, comparer ses réponses, tenir compte de l’open source, mais garder un regard critique sur les zones d’ombre. C’est précisément là que se joue l’intérêt de DeepSeek, non dans l’inconnu lui-même, mais dans ce qu’il oblige à éclairer.
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
- Application productivité : 6 outils pour reprendre le contrôle de vos journées - 14 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Formation Claude IA sur choisir-formation.com : prix, formats et critères pour éviter un mauvais achat
 Financement de logiciels SaaS : trésorerie, dilution et solutions selon votre stade
 Alternance, RNCP, métiers : le trio à comparer pour une formation en management numérique en région parisienne
 Data, cyber, cloud ou dev : quel métier tech choisir selon votre profil ?