DeepSeek R2 face à ChatGPT, Gemini et Copilot : multilingue, code et inférence locale
DeepSeek R2 désigne la nouvelle génération de modèle d’intelligence artificielle de DeepSeek, attendue comme une réponse directe aux grands systèmes généralistes tels que ChatGPT, Gemini, Microsoft Copilot ou les modèles d’Anthropic. L’intérêt du projet tient moins à son origine qu’à son positionnement : un modèle présenté comme plus sobre à l’inférence, multilingue, multimodal et plus simple à intégrer dans des environnements techniques variés.
Ce que DeepSeek R2 cherche vraiment à changer
DeepSeek R2 s’inscrit dans une course où la performance brute ne suffit plus. Les entreprises, les développeurs et les éditeurs de logiciels regardent désormais trois critères en même temps : la qualité du raisonnement, le coût d’exploitation et la capacité à déployer l’IA là où les données se trouvent déjà. C’est sur ce terrain que DeepSeek tente de se différencier, avec un discours centré sur la sobriété et l’intégration.
Un modèle pensé comme challenger des leaders occidentaux
Face à GPT-4, Gemini, Copilot ou Anthropic, DeepSeek R2 n’est pas présenté comme un simple chatbot de plus. Son intérêt repose sur une combinaison de capacités : raisonnement logique, génération de code, traitement texte-image, compatibilité API, accès web et application mobile. Le lancement annoncé autour d’avril 2025, puis évoqué comme avancé aux prochaines semaines, a renforcé l’idée d’une sortie stratégique destinée à mettre la pression sur le marché.
Cette dimension concurrentielle compte beaucoup. Un modèle performant mais coûteux reste difficile à généraliser dans les usages quotidiens. À l’inverse, un modèle moins cher mais peu fiable ne convainc pas les équipes techniques. DeepSeek R2 cherche donc à occuper un espace intermédiaire : proposer une IA ambitieuse, avec une logique de déploiement plus pragmatique et des coûts d’usage mieux maîtrisés.
Le multilinguisme comme enjeu de marché
L’un des points les plus commentés est le multilinguisme natif. L’objectif n’est pas seulement de traduire correctement une réponse en français, en espagnol ou en chinois, mais de raisonner dans plusieurs langues sans ramener systématiquement la logique du modèle vers l’anglais. Pour des organisations internationales, cela peut changer la qualité des analyses juridiques, documentaires, du support client ou des usages métiers.
Ce point est aussi stratégique : une IA qui comprend mieux les nuances linguistiques locales réduit le besoin de fine-tuning régional lourd et peut s’adapter plus vite à des marchés non anglophones. C’est l’une des raisons pour lesquelles DeepSeek R2 est observé au-delà du cercle des ingénieurs IA, notamment par les équipes produit et les directions techniques qui cherchent une base plus souple pour leurs déploiements.
Les innovations techniques qui expliquent l’intérêt
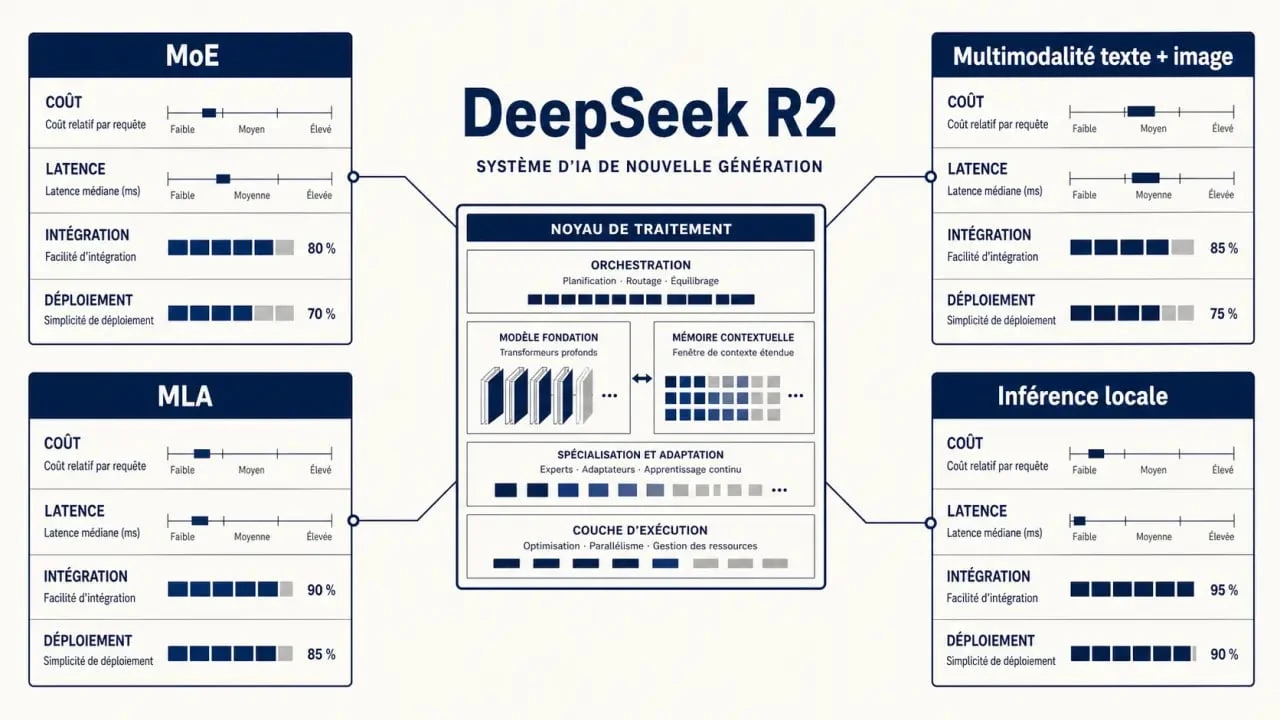
DeepSeek R2 concentre plusieurs briques techniques déjà connues dans l’écosystème IA, mais les articule autour d’un objectif clair : obtenir davantage d’efficacité à l’usage. Les termes MoE, MLA ou inférence locale peuvent sembler abstraits ; leur importance se mesure surtout dans les coûts, la vitesse et les possibilités d’intégration. Le point commun reste le même : faire mieux avec moins de calcul.
Docs officielles DeepSeek pour démarrer avec l’API · Découvrez la documentation officielle pour effectuer votre premier appel API DeepSeek et l’intégrer facilement avec les SDK OpenAI ou Anthropic.
MoE et MLA : puissance ciblée, calcul mieux utilisé
L’architecture MoE, pour Mixture-of-Experts, repose sur une idée simple : tous les paramètres du modèle ne sont pas mobilisés de la même façon pour chaque requête. Le système active les experts les plus pertinents selon la tâche, au lieu de solliciter toute la machine à pleine puissance. Cela peut contribuer à réduire les coûts d’inférence et à améliorer la sobriété du modèle.
La brique MLA, pour Multi-head Latent Attention, vise de son côté à optimiser l’attention, c’est-à-dire la manière dont le modèle relie les éléments importants d’une requête longue ou complexe. Associée à MoE, cette approche est présentée comme l’une des raisons des coûts d’inférence annoncés comme pouvant être jusqu’à 40x inférieurs. Ce chiffre est central, car il touche directement le coût total de possession pour les entreprises et la capacité à passer à l’échelle.
Code, multimodalité et audio en bêta
DeepSeek R2 met aussi en avant la génération et l’optimisation de code, avec le support de plus de 30 langages de programmation. Les usages attendus dépassent l’autocomplétion : refactorisation, détection de failles, génération de tests unitaires, compréhension d’un dépôt existant ou aide à la migration technique. Les benchmarks cités dans l’écosystème, comme HumanEval, MBPP ou CodeContests, montrent que le code reste un terrain de comparaison incontournable.
Le modèle est également décrit comme nativement multimodal texte + image, avec une version audio en bêta. Cela ouvre la voie à l’analyse de documents scannés, de captures d’écran, de schémas industriels ou de photos terrain. Dans un SAV, par exemple, l’IA peut croiser une description écrite avec une image de panne. Dans un service documentaire, elle peut extraire des données structurées depuis un visuel complexe sans obliger l’utilisateur à tout retranscrire manuellement.
DeepSeek R2 face à ChatGPT, Gemini, Copilot et Anthropic
La comparaison avec les modèles concurrents doit rester prudente : selon les cas, les performances varient fortement en fonction des prompts, des langues, des outils connectés et des contraintes de sécurité. Mais DeepSeek R2 se distingue par un positionnement moins centré sur l’interface de conversation grand public et plus orienté infrastructure, intégration et optimisation. Son angle est celui d’un modèle de production avant tout.
| Solution | Positionnement dominant | Différence notable |
|---|---|---|
| DeepSeek R2 | Modèle multilingue, multimodal, orienté efficacité et intégration | MoE + MLA, coûts d’inférence annoncés jusqu’à 40x inférieurs, inférence locale possible |
| GPT-4 / ChatGPT | Assistant généraliste très installé dans les usages | Écosystème mature, forte adoption grand public et professionnelle |
| Gemini | IA intégrée à l’écosystème Google | Intérêt fort pour les usages liés aux services Google et à la multimodalité |
| Microsoft Copilot | Assistant productivité et entreprise | Intégration naturelle dans les outils Microsoft et les environnements bureautiques |
| Anthropic | Modèles conversationnels orientés raisonnement et sécurité | Positionnement marqué sur les réponses longues, la prudence et l’usage professionnel |
La vraie question n’est donc pas de savoir si DeepSeek R2 « remplace » un concurrent dans tous les scénarios. Il faut plutôt regarder où il peut devenir plus pertinent : grands volumes de requêtes, contraintes de coût, besoins multilingues, traitements locaux, intégration dans des pipelines existants ou déploiement sur appareils. C’est là que le modèle prend une valeur très concrète.
Une bonne manière de comprendre l’intérêt de DeepSeek R2 consiste à penser l’IA comme une logique distribuée dans l’organisation. Si elle reste concentrée dans un outil cloud isolé, son impact dépend de quelques usages visibles. Si elle se diffuse dans les applications métiers, les terminaux, les chaînes documentaires et les objets connectés, elle modifie la façon dont l’information circule. La latence, la confidentialité, la bande passante et la proximité avec la donnée deviennent alors aussi importantes que la qualité de la réponse. C’est précisément là que l’inférence locale et l’edge computing peuvent faire la différence.
Usages concrets : où DeepSeek R2 peut créer de la valeur
Les cas d’usage les plus crédibles sont ceux où la combinaison coût, code, multimodalité et déploiement local apporte un avantage tangible. DeepSeek R2 intéresse particulièrement les équipes techniques, mais aussi les organisations qui manipulent beaucoup de documents, d’images ou de données sensibles. Son intérêt tient à la fois à la productivité et au contrôle.
Développement logiciel et pipelines existants
Pour les développeurs, l’intérêt tient à la possibilité d’intégrer le modèle via API ou dans des chaînes déjà en place. La compatibilité mentionnée avec HuggingFace, Triton, ONNX et un runtime maison facilite cette logique d’intégration. Les briques open source citées, comme Flat MLA, Deep GEM et Deep EP, renforcent aussi l’idée d’un écosystème technique plus ouvert et modulable.
Dans une équipe logicielle, DeepSeek R2 peut servir à générer du code, relire des pull requests, expliquer une base legacy ou produire des tests. La valeur ne vient pas seulement de la réponse ponctuelle, mais de l’automatisation de tâches répétitives sans faire grimper les coûts d’inférence lorsque les volumes augmentent. Pour les organisations qui industrialisent leurs usages IA, cette stabilité compte autant que la qualité de génération.
Entreprise, confidentialité et déploiement local
L’inférence locale répond à une préoccupation très concrète : éviter que certaines données sensibles transitent systématiquement par un cloud externe. Pour une banque, un industriel, un acteur public ou une entreprise de santé, cette dimension peut peser autant que les performances du modèle. Le déploiement on-prem ou embarqué permet de rapprocher l’IA des données, avec moins de dépendance réseau et davantage de contrôle.
Cette approche est aussi pertinente pour les appareils à ressources limitées : smartphones, téléviseurs, objets connectés, assistants vocaux offline ou équipements domestiques. Les noms de constructeurs comme Haier, TCL, Hisense, Honor ou Oppo apparaissent dans l’écosystème autour de ces usages, ce qui illustre une tendance plus large : l’IA ne reste plus cantonnée au navigateur, elle entre dans les objets du quotidien et dans les interfaces métiers.
Points de vigilance avant d’y voir une alternative évidente
DeepSeek R2 a de solides arguments, mais son adoption ne doit pas être décidée sur la seule promesse technologique. Les équipes doivent évaluer la disponibilité réelle, les conditions de licence, la stabilité des API, la documentation, la sécurité, la conformité et la qualité des réponses dans leurs propres langues et métiers. Ces points restent décisifs dès qu’un modèle entre dans un cadre de production.
Il faut aussi distinguer les démonstrations, les benchmarks et les performances en production. Un modèle peut exceller sur une tâche de code, mais se montrer moins régulier sur des documents internes ambigus. Il peut réduire les coûts d’inférence, tout en nécessitant des compétences d’intégration, d’observabilité et de maintenance. Le gain économique dépend donc du volume de requêtes, de l’infrastructure choisie et du niveau d’exigence métier.
La conclusion la plus raisonnable est que DeepSeek R2 représente une alternative crédible à surveiller, surtout pour les organisations qui cherchent à réduire leur dépendance au cloud, maîtriser leurs coûts et déployer l’IA dans plusieurs langues ou environnements techniques. Son potentiel est réel, mais il se vérifiera moins dans les annonces que dans les tests comparatifs, les intégrations concrètes et la qualité obtenue sur des cas d’usage métier.
- Office 365 cloud computing : choisissez entre suite bureautique, services cloud et PC Cloud - 18 septembre 2026
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Logiciel paie automatisé : gagner du temps sur les variables, les contrôles et l’archivage
 DeepSeek avis : une alternative crédible pour le code, les gros volumes et les budgets API
 DeepSeek, l’IA chinoise qui bouscule ChatGPT par son coût réduit, son open weight et ses limites de censure
 App Shopify ou routage avancé : quel logiciel de gestion de tournées e-commerce choisir ?