DeepSeekMath : 120B de tokens, GRPO et trois versions 7B pour raisonner en maths
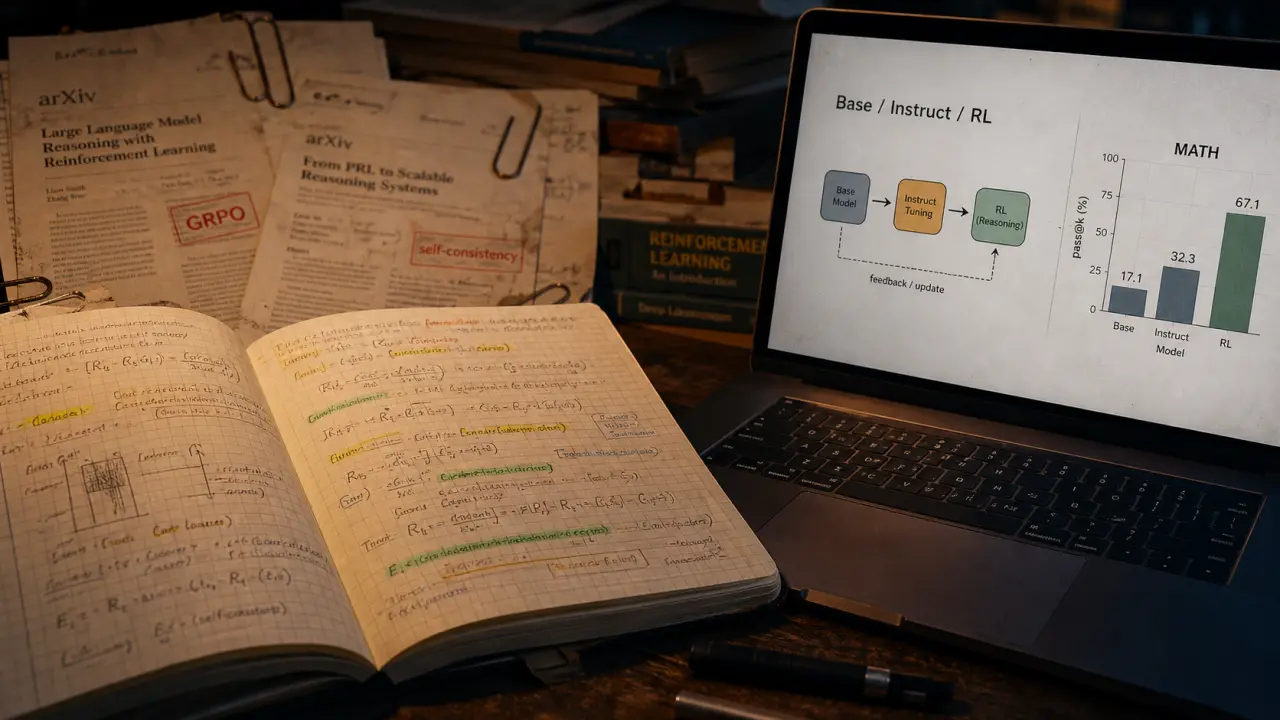
DeepSeekMath désigne une famille de modèles 7B spécialisés dans le raisonnement mathématique. Le projet ne se limite pas à résoudre des exercices. Il réunit un papier de recherche, des checkpoints publics, des exemples d’inférence et une méthode d’entraînement suffisamment détaillée pour être étudiée ou réutilisée par des équipes techniques.
Pour qui veut vérifier les performances, comprendre les variantes disponibles ou tester le modèle avec Transformers, DeepSeekMath se situe entre la publication académique et l’outil open source. Les points clés à retenir sont simples : son origine, ses résultats sur les benchmarks, sa méthode de collecte des données et ses usages concrets.
Ce qu’est DeepSeekMath, et pourquoi il part d’un modèle de code
DeepSeekMath 7B dérive de DeepSeek-Coder-Base-v1.5 7B. Ce choix est cohérent avec la tâche visée. Le code impose une logique séquentielle, une gestion stricte des symboles et une attention aux contraintes. Ces qualités se rapprochent de celles qu’exige un raisonnement mathématique, qu’il s’agisse de démontrer, calculer ou décomposer un problème.
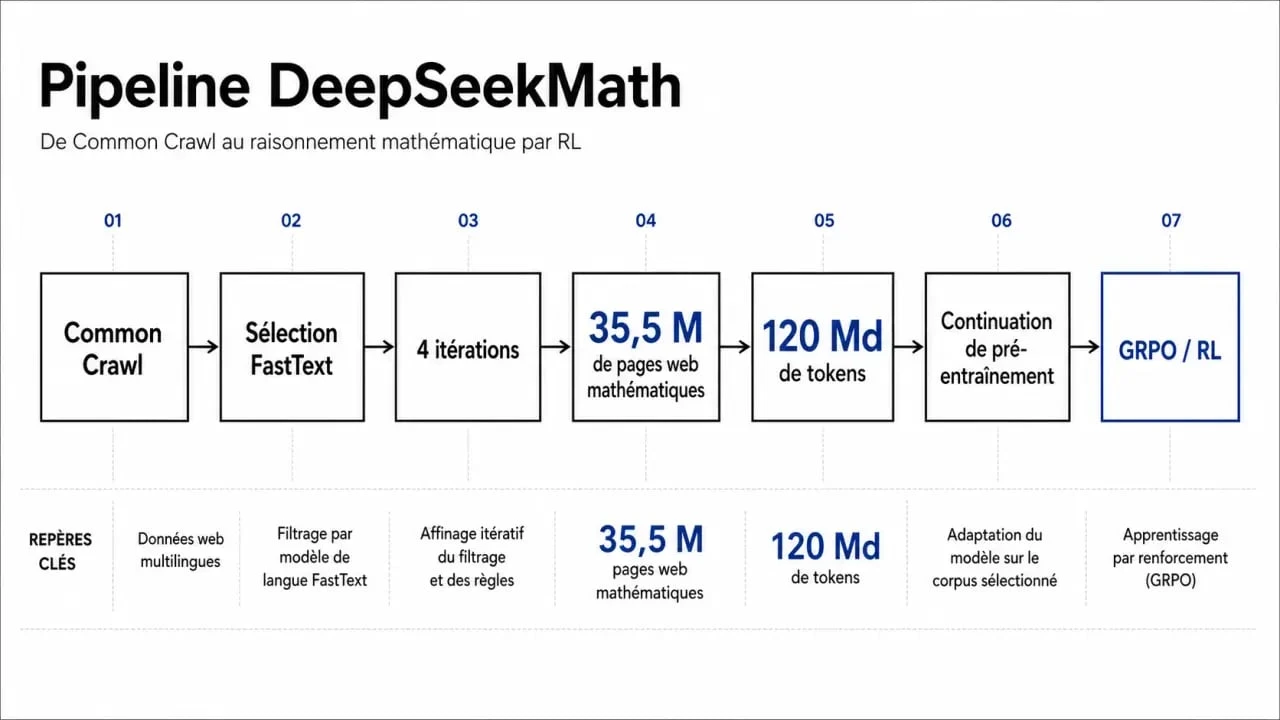
Le modèle n’est donc pas un LLM généraliste auquel on aurait simplement ajouté quelques exemples d’algèbre. Il repose sur une continuation de pré-entraînement orientée mathématiques, avec 120B de tokens liés aux maths. Cette étape vise à renforcer les représentations utiles pour les équations, les raisonnements pas à pas, les énoncés de compétition et les textes mathématiques présents sur le web.
Base, Instruct et RL : trois versions pour trois usages
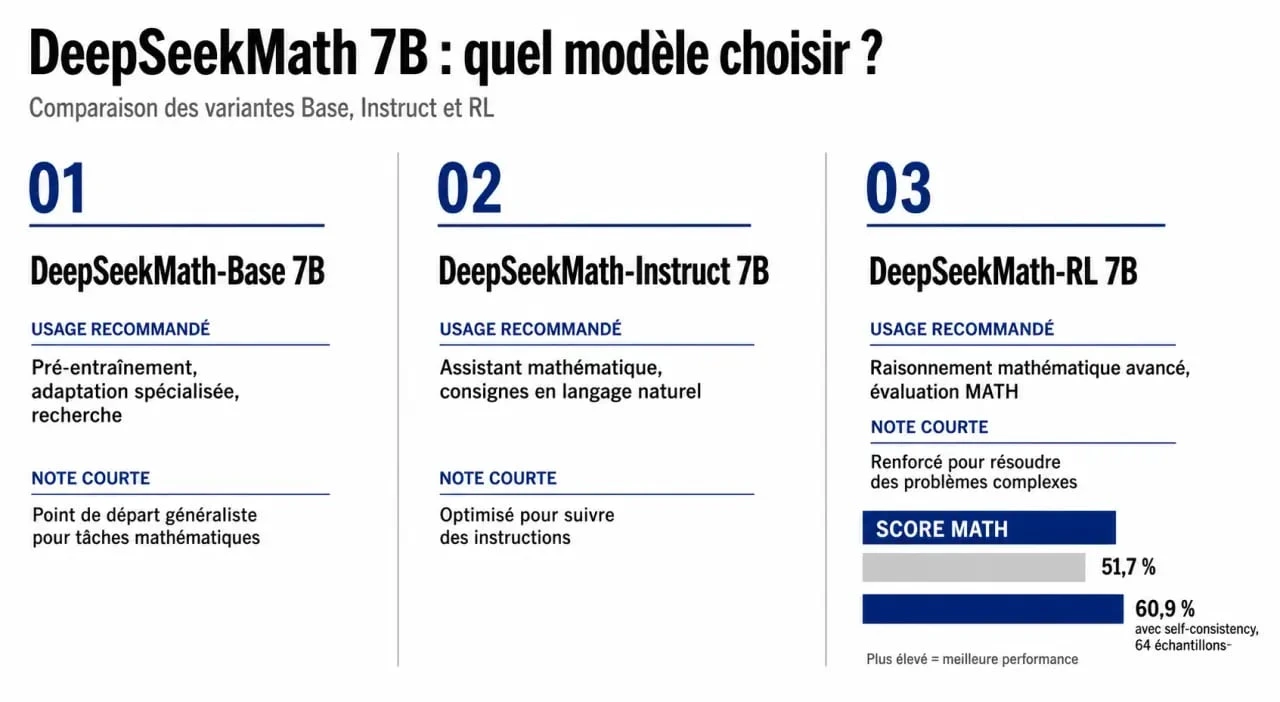
La famille DeepSeekMath comprend des checkpoints 7B en variantes base, instruct et RL. La version base sert surtout à la recherche, à l’évaluation brute et à d’éventuels fine-tunings. La version instruct répond plus naturellement aux consignes, car elle a été alignée pour traiter des demandes en langage courant. La version RL, construite à partir de la version instruct, pousse davantage le raisonnement grâce à l’apprentissage par renforcement.
| Variante | Rôle principal | Usage conseillé |
|---|---|---|
| DeepSeekMath-Base 7B | Modèle pré-entraîné spécialisé | Recherche, fine-tuning, comparaison contrôlée |
| DeepSeekMath-Instruct 7B | Réponses à des consignes | Chat completion, résolution guidée, assistants éducatifs |
| DeepSeekMath-RL 7B | Raisonnement renforcé | Problèmes complexes, benchmarks, chaînes de raisonnement |
Performances : ce que disent les benchmarks MATH et la self-consistency
DeepSeekMath-RL 7B obtient 51,7 % sur le benchmark MATH, un ensemble réputé exigeant pour mesurer la résolution de problèmes de niveau compétition. Avec la self-consistency sur 64 samples, le score atteint 60,9 % sur MATH. L’écart est net. Il montre que le modèle profite d’un échantillonnage multiple, puis d’une sélection ou d’une agrégation de réponses plus robuste.
La self-consistency ne rend pas le modèle plus performant à elle seule. Elle exploite surtout le fait qu’un modèle capable de générer plusieurs raisonnements peut parfois produire une bonne solution même si une première tentative échoue. En pratique, cela coûte plus cher en inférence, car 64 échantillons demandent beaucoup plus de calcul qu’une réponse unique. Le gain peut toutefois se justifier pour des tâches critiques ou pour une évaluation plus stable.
Sans outil externe, avec outil, et preuve formelle
Les résultats mis en avant couvrent plusieurs cadres : résolution sans outil externe, tool use et formal theorem proving. Cette distinction compte. Un modèle qui répond sans outil montre une capacité interne de raisonnement et de calcul symbolique. Un modèle avec tool use peut déléguer certaines étapes à un solveur, à un interpréteur ou à un environnement formel, ce qui change la nature de la performance.
Pour une intégration produit, il faut donc décider si l’objectif est de générer une solution pédagogique lisible, de produire une réponse vérifiée par un outil, ou de servir d’interface entre l’utilisateur et un moteur mathématique. DeepSeekMath est intéressant précisément parce qu’il peut être évalué dans ces différents modes, sans changer de famille de modèle.
Données et entraînement : le pipeline qui explique une partie des gains
Le corpus mathématique est un élément central du projet. La collecte s’appuie sur Common Crawl, avec une sélection initiale via FastText, puis une procédure itérative. Après 4 itérations de collecte, l’équipe mentionne 35,5M de pages web mathématiques. Cette masse de documents sert à constituer les 120B de tokens mathématiques utilisés pour la continuation de pré-entraînement.
Le point important n’est pas seulement le volume. En mathématiques, un corpus mal filtré peut accumuler des pages superficielles, des corrigés erronés ou des fragments de notation peu exploitables. La démarche itérative permet de raffiner progressivement ce qui ressemble vraiment à du contenu mathématique utile : énoncés, démonstrations, exercices, explications, formules et raisonnements structurés.
GRPO : une variante de PPO pensée pour le raisonnement
DeepSeekMath utilise GRPO, pour Group Relative Policy Optimization, présenté comme une variante de PPO. L’idée générale est d’améliorer la politique de génération du modèle en comparant des réponses au sein d’un groupe, plutôt qu’en s’appuyant uniquement sur une estimation classique de valeur. Pour l’utilisateur final, l’effet recherché est simple : obtenir des réponses qui suivent mieux une trajectoire de raisonnement correcte.
On peut voir un bon raisonnement mathématique comme un soufflet. Il doit se déployer étape par étape, puis revenir vers une conclusion compacte. Si les plis sont mal formés, la solution devient longue mais fragile. Si l’expansion est trop courte, elle saute des justifications. Cette image aide à lire les sorties du modèle : une bonne réponse ne se contente pas d’empiler des lignes, elle garde une amplitude contrôlée entre exploration, calcul intermédiaire et résultat final.
Accès au papier, au dépôt et aux checkpoints
DeepSeekMath est documenté publiquement via le papier arXiv et le dépôt GitHub de DeepSeek AI. Le papier, identifié par arXiv 2402.03300, détaille la méthode et les résultats. Le dépôt GitHub rassemble les informations pratiques : résultats d’évaluation, collecte de données, liens vers les modèles, exemples de text completion et de chat completion.
Les checkpoints base, instruct et RL sont disponibles publiquement, notamment pour un usage avec Hugging Face et la bibliothèque Transformers. La licence du modèle est explicitement mentionnée dans les ressources officielles, avec possibilité d’usage commercial sous conditions. Avant une intégration en production, il reste indispensable de relire les termes exacts de la licence, surtout si les sorties sont intégrées à un service payant ou à un outil éducatif à grande échelle.
- Consulter le papier DeepSeekMath sur arXiv
- Accéder au dépôt GitHub DeepSeekMath
- Voir les modèles DeepSeek AI sur Hugging Face
Ce qu’il faut vérifier avant de lancer une inférence
Avant de tester le modèle, vérifiez la variante choisie, le format de prompt attendu et les ressources matérielles disponibles. Une version instruct sera généralement plus simple pour poser une question en langage naturel, tandis qu’une version base demande davantage de préparation. Pour la chat completion, l’application correcte du chat template compte autant que le prompt lui-même.
Il faut aussi distinguer un test exploratoire d’une évaluation sérieuse. Pour comparer DeepSeekMath à un autre modèle, utilisez les mêmes jeux de problèmes, la même température, le même nombre d’échantillons et les mêmes règles de correction. Sans ce cadre, une réponse spectaculaire sur un exercice isolé ne dit pas grand-chose sur la robustesse réelle.
Pour quels usages DeepSeek Math est vraiment pertinent
DeepSeek Math convient d’abord aux profils qui ont besoin d’un modèle ouvert et spécialisé : chercheurs en IA, développeurs d’outils éducatifs, équipes qui travaillent sur le raisonnement automatique, ou entreprises qui veulent tester un modèle 7B sans dépendre uniquement d’une API propriétaire. Son format 7B le rend plus accessible que des modèles beaucoup plus grands, même si l’inférence reste à dimensionner correctement.
Dans un assistant pédagogique, il peut générer des pistes de résolution, reformuler un raisonnement ou proposer des étapes intermédiaires. Dans un cadre plus technique, il peut servir à comparer des méthodes de prompting, tester la self-consistency, connecter un modèle à des outils de calcul ou expérimenter le theorem proving. Sa valeur augmente quand il s’intègre dans une chaîne contrôlée plutôt que lorsqu’il est laissé seul face à toutes les demandes.
Ses limites doivent rester claires : un score élevé sur MATH ne garantit pas une exactitude parfaite, et une explication fluide peut masquer une erreur de calcul ou une hypothèse oubliée. Pour des usages sensibles, la meilleure approche consiste à combiner DeepSeekMath avec une vérification symbolique, des tests unitaires, une relecture humaine ou des outils spécialisés. Le modèle devient alors un composant solide d’un système, pas une boîte noire à qui l’on délègue toute la vérité mathématique.
- Office 365 cloud computing : choisissez entre suite bureautique, services cloud et PC Cloud - 18 septembre 2026
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Formateur en intelligence artificielle : compétences, contenus et tarifs à comparer
 Alternance, RNCP, métiers : le trio à comparer pour une formation en management numérique en région parisienne
 Data, cyber, cloud ou dev : quel métier tech choisir selon votre profil ?
 DeepSeek : performance, censure et puces, que cache vraiment ce modèle chinois ?