OpenRouter DeepSeek : V4 Pro pour 1M de contexte, V4 Flash pour maîtriser le coût
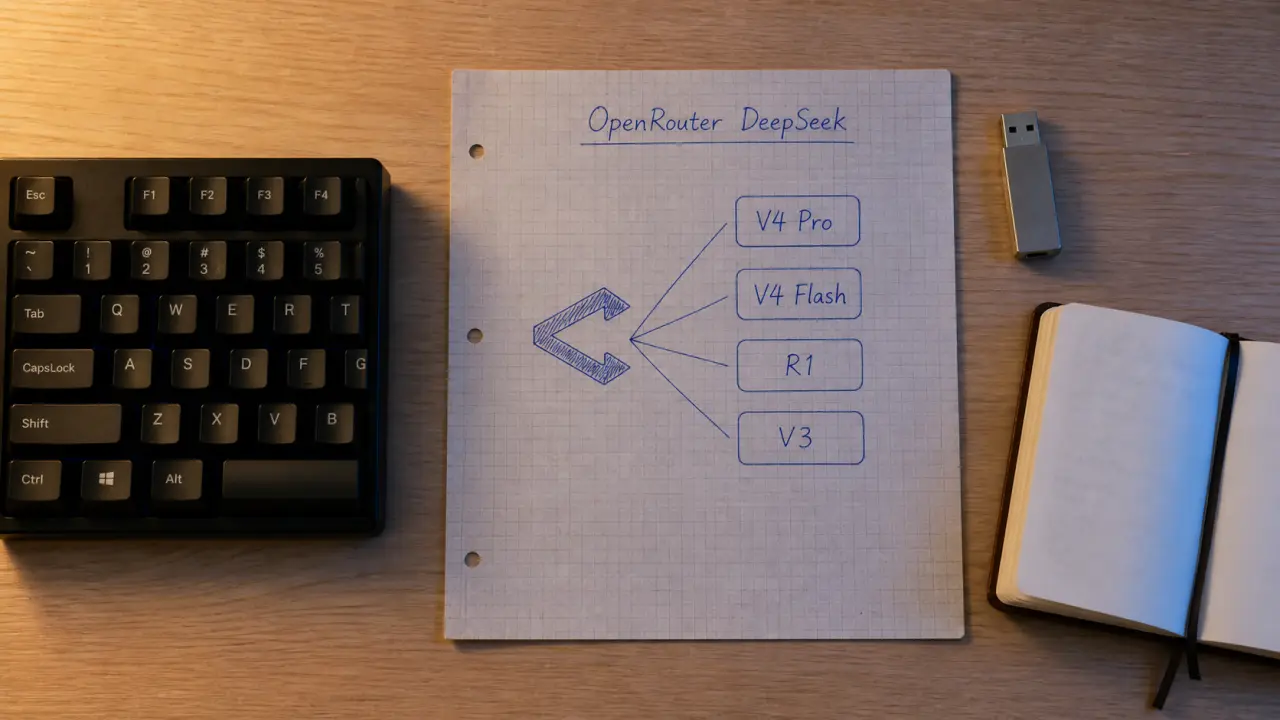
OpenRouter DeepSeek intéresse surtout les développeurs qui veulent accéder aux modèles DeepSeek sans gérer une intégration isolée, une clé par fournisseur ou un changement d’API à chaque test. L’enjeu est simple : choisir le bon modèle selon le budget, le contexte nécessaire, le niveau de raisonnement attendu et la charge de travail visée, qu’il s’agisse de codage, d’agent, d’analyse longue ou d’expérimentation rapide.
Ce que permet OpenRouter avec les modèles DeepSeek
OpenRouter sert de couche d’accès unifiée aux modèles d’IA. Au lieu d’intégrer chaque fournisseur séparément, vous envoyez vos requêtes vers une API centralisée, compatible avec des usages proches de l’écosystème OpenAI. Pour DeepSeek, cela simplifie les tests comparatifs : vous pouvez passer d’un modèle à l’autre, ajuster votre routage et suivre vos coûts sans refondre toute l’application.
Cette approche répond à un problème très concret : les équipes qui construisent des assistants, des agents ou des outils internes doivent souvent arbitrer entre qualité, latence, prix et disponibilité. OpenRouter permet de router les requêtes, de tester plusieurs modèles et de limiter la dépendance à un seul endpoint. C’est utile quand un modèle sert à des tâches variables : génération de code un jour, analyse documentaire le lendemain, raisonnement multi-étapes ensuite.
Pourquoi DeepSeek attire autant dans ce contexte
DeepSeek se distingue par une combinaison rare : modèles puissants, architecture optimisée, prix agressifs sur certaines variantes et capacités adaptées aux usages agentiques. Les notions de Mixture-of-Experts, de paramètres activés et de fenêtre de contexte longue ne sont pas de simples arguments marketing : elles influencent directement le coût d’exécution, la quantité d’information traitable et la pertinence sur les tâches complexes.
Sur OpenRouter, DeepSeek devient donc une option intéressante pour les profils qui veulent expérimenter sans s’enfermer. Un développeur peut brancher un assistant de code, une startup peut évaluer un pipeline d’analyse, une équipe produit peut tester un agent autonome, puis comparer les résultats avec d’autres modèles disponibles dans la même interface.
V4 Pro, V4 Flash, R1, V3 : quel modèle DeepSeek choisir ?
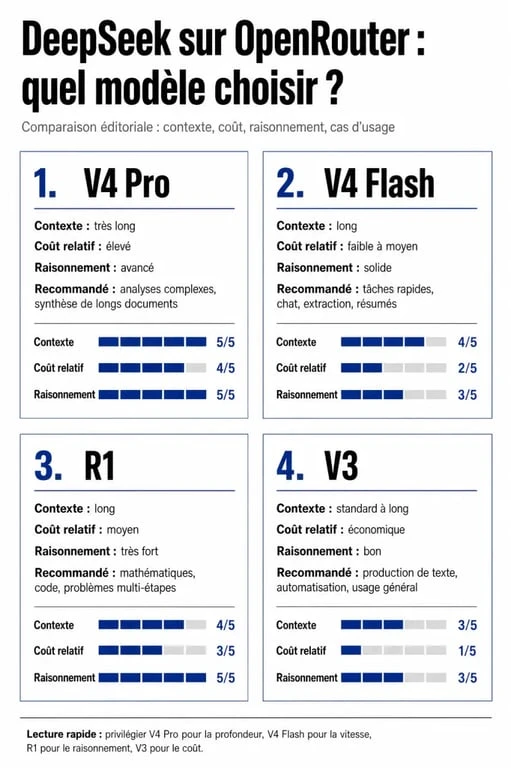
Le bon choix dépend moins du nom du modèle que du compromis recherché. V4 Pro vise les tâches longues et complexes, V4 Flash cible le coût et le débit, R1 reste pertinent pour le raisonnement, tandis que V3 garde un intérêt pour certains usages généralistes et techniques.
Comparer les modèles DeepSeek, tarifs, contextes et performances · Consultez la page de référence pour comparer les tarifs, fenêtres de contexte, benchmarks et capacités des différents modèles DeepSeek sur OpenRouter.
| Modèle | Repères techniques | Contexte | Usage recommandé |
|---|---|---|---|
| DeepSeek V4 Pro | 1.6T total parameters, 49B activated parameters, architecture Mixture-of-Experts, système d’attention hybride | 1M tokens | Analyse de grands volumes, workflows agentiques longs, codebases étendues |
| DeepSeek V4 Flash | Endpoint le moins cher de la gamme V4 mentionnée | Selon endpoint disponible | Workloads agentiques à fort volume, automatisations, tests coût-performance |
| DeepSeek R1 | 671B total parameters, 37B active parameters | 164 000 tokens | Raisonnement, résolution de problèmes, tâches multi-étapes |
| DeepSeek V3 | 685B total parameters, 134B active parameters, pré-entraîné sur près de 15 trillion tokens | 164 000 tokens | Usage général avancé, génération, analyse et codage selon besoin |
V4 Pro : le choix du contexte long
DeepSeek V4 Pro est le modèle à considérer quand la fenêtre de contexte devient le facteur décisif. Avec un context window de 1M tokens, il peut absorber des documents longs, des historiques d’interaction, des spécifications produit ou une base de code beaucoup plus large qu’un modèle limité à quelques dizaines de milliers de tokens. Ses 1.6T total parameters et 49B activated parameters reflètent une architecture large-scale Mixture-of-Experts, pensée pour n’activer qu’une partie du modèle selon la requête.
Le support des reasoning efforts high et xhigh, avec un mapping vers le max reasoning, le rend aussi pertinent pour des scénarios où l’on accepte une réflexion plus coûteuse en échange d’une meilleure tenue logique : planification, arbitrage technique, analyse d’incidents ou synthèse contradictoire.
V4 Flash : le choix du volume et du prix
DeepSeek V4 Flash se distingue par son positionnement économique. Le tarif indiqué est de $0.09 input / $0.18 output per million tokens, ce qui en fait un candidat naturel pour les tâches nombreuses, répétitives ou agentiques. À titre de contraste, un prix de $5 input / $30 output per million tokens change complètement l’équation lorsqu’un agent génère de longues chaînes de raisonnement et multiplie les appels.
Cette différence compte parce que les workloads agentiques consomment beaucoup plus de tokens qu’un simple chat humain. Un agent lit, planifie, appelle des outils, vérifie, reformule et relance parfois plusieurs étapes. Le modèle le plus “intelligent” n’est donc pas toujours le meilleur choix économique. Le bon modèle est souvent celui qui produit une qualité suffisante au coût marginal le plus bas.
Prix, adoption et logique coût-performance
Le prix de DeepSeek sur OpenRouter doit être lu en coût par million de tokens, mais aussi en coût total de workflow. Une requête courte de classification ne pèse pas comme un agent qui explore un dépôt, résume dix fichiers, génère un correctif puis vérifie ses propres hypothèses. C’est là que V4 Flash prend de la valeur : son faible coût autorise davantage d’itérations sans rendre le prototype économiquement absurde.
Les volumes d’usage confirment cette dynamique : plus le coût baisse, plus les utilisateurs osent automatiser. Sur une période de 6 mois, plus de 450 trillion tokens ont été observés dans les flux analysés autour de ces usages. DeepSeek a aussi vu sa part progresser, avec des repères comme 10%, 5%, 20%, 9% ou 18% selon les segments et les moments observés. Ces chiffres ne remplacent pas un benchmark interne, mais ils montrent que l’adoption repose sur un usage réel, pas seulement sur la curiosité.
Quand le modèle le moins cher n’est pas forcément le plus rentable
Un modèle moins cher peut devenir plus coûteux s’il échoue souvent, hallucine davantage ou nécessite trois relances pour obtenir une réponse exploitable. Pour choisir, il faut donc mesurer le coût par tâche réussie, pas seulement le coût par token. Sur du nettoyage de données, de la transformation de texte ou de la génération de brouillons, V4 Flash peut suffire. Sur une migration de code sensible ou une analyse réglementaire complexe, V4 Pro ou R1 peuvent réduire les reprises humaines.
Un bon protocole consiste à tester 30 à 50 prompts représentatifs, puis à comparer trois indicateurs : taux de réponse acceptable, coût moyen par résultat validé et latence perçue. Ce test simple révèle souvent qu’un mix de modèles est préférable : Flash pour les étapes simples, Pro ou R1 pour les décisions difficiles.
Cas d’usage où OpenRouter DeepSeek est particulièrement pertinent
DeepSeek via OpenRouter convient aux usages où l’on veut combiner puissance, flexibilité et maîtrise du coût. Les cas les plus évidents sont le codage, l’analyse de codebase, les agents autonomes, la synthèse de documents longs et les pipelines de traitement à fort volume.
Codage, refactoring et analyse de base de code
Pour le développement logiciel, le contexte long change la méthode de travail. Au lieu de demander au modèle de corriger une fonction isolée, vous pouvez lui fournir davantage d’architecture, de conventions internes, de tests et de dépendances. V4 Pro, avec son contexte 1M, devient intéressant pour comprendre un système plutôt qu’un fragment. R1 peut être utile lorsque la tâche demande de raisonner étape par étape sur une erreur, une régression ou un choix d’architecture.
Il ne faut toutefois pas tout envoyer sans tri. Un bon prompt de code inclut les fichiers concernés, les contraintes de style, les logs pertinents et le résultat attendu. Plus le contexte est grand, plus l’organisation de l’information compte : un modèle puissant reste sensible au bruit.
Agents et workflows long-horizon
Les agents ont besoin de mémoire de travail, de capacité de planification et d’un coût supportable. Ils peuvent exécuter une recherche, générer une hypothèse, appeler un outil, analyser la sortie, puis corriger leur trajectoire. Dans cette logique, V4 Flash est souvent adapté aux boucles fréquentes, tandis que V4 Pro intervient pour les synthèses lourdes ou les décisions à fort enjeu.
Le contexte d’un agent doit rester stable. Il ne s’agit pas d’empiler tous les documents disponibles, mais de conserver les objectifs, les contraintes, les décisions déjà prises, les erreurs à ne pas répéter et les sorties d’outils importantes dans un ensemble clair. Cette méthode réduit le bruit, évite que l’agent se disperse et améliore la continuité entre les étapes, surtout quand le workflow dure longtemps.
Utiliser DeepSeek via l’API OpenRouter sans complexifier son stack
Pour démarrer, le parcours est simple : créer un compte OpenRouter, générer une clé dans la section API Keys, choisir un modèle DeepSeek depuis la page modèle ou le catalogue, puis appeler l’endpoint OpenRouter. La compatibilité OpenAI-compatible facilite l’intégration dans de nombreux projets existants, car les développeurs peuvent souvent adapter leur configuration plutôt que réécrire toute la couche client.
- Créer un compte sur OpenRouter.
- Générer une clé API depuis le dashboard, dans la section API Keys.
- Choisir le modèle DeepSeek adapté : V4 Flash pour le coût, V4 Pro pour le contexte, R1 pour le raisonnement.
- Configurer l’endpoint OpenRouter dans votre client compatible OpenAI.
- Mesurer les coûts, la latence et le taux de succès sur vos propres prompts.
L’intérêt principal est la réversibilité. Si votre application utilise déjà une interface proche de l’OpenAI SDK, OpenRouter peut servir de point de routage pour tester DeepSeek, comparer avec d’autres modèles et mettre en place des fallbacks. Cette logique évite le refactoring coûteux à chaque changement de fournisseur et permet de construire un système plus robuste.
En pratique, OpenRouter DeepSeek est donc un bon choix si vous voulez accéder rapidement à des modèles performants, tester plusieurs variantes et optimiser votre coût par résultat. V4 Flash répond aux besoins de volume, V4 Pro aux besoins de contexte massif, R1 aux scénarios de raisonnement, et V3 reste une option solide pour des usages généralistes avancés. Le meilleur choix n’est pas universel : il se vérifie sur vos prompts, vos contraintes et votre budget réel.
- Office 365 cloud computing : choisissez entre suite bureautique, services cloud et PC Cloud - 18 septembre 2026
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Midjourney essai gratuit : 25 images, accès variable et alternatives sans payer
 CRM avec intelligence artificielle : automatiser, scorer, prévoir et mesurer le ROI
 Intelligence artificielle en banque : usages concrets, gains mesurables et risques à maîtriser
 Logiciel de gestion de congés open source : gratuité, flexibilité, limites à connaître