DeepSeek V4-Pro ou V4-Flash : le bon choix pour le code, les agents et le long contexte ?
DeepSeek V4 regroupe la nouvelle génération de modèles de DeepSeek, avec deux noms qui reviennent souvent : DeepSeek V4-Pro, le modèle phare, et DeepSeek V4-Flash, la variante pensée pour la vitesse et les usages agentiques. Le point décisif tient à l’usage réel : coder, raisonner, analyser de longs dossiers, automatiser un workflow ou comparer une alternative aux modèles propriétaires comme GPT, Claude ou Opus.
Ce que recouvre vraiment DeepSeek V4
DeepSeek V4 n’est pas un simple changement de nom. Cette génération met en avant des capacités de raisonnement, de programmation, de mathématiques et d’analyse longue. Le modèle le plus mis en avant est DeepSeek-V4-Pro, présenté comme le modèle phare de cette version. Il repose sur une architecture Mixture-of-Experts, avec 1 600 milliards de paramètres au total et 49 milliards actifs lors de l’inférence.
Cette architecture mérite d’être expliquée simplement. Au lieu de mobiliser tout le réseau pour chaque demande, un système Mixture-of-Experts active une partie spécialisée du modèle selon la tâche. L’objectif est clair : garder une forte puissance globale tout en limitant le travail inutile sur les requêtes plus ciblées. C’est ce qui rend DeepSeek V4 intéressant pour des sujets techniques, où la précision du raisonnement compte autant que la capacité brute.
V4-Pro : le modèle de référence pour les tâches difficiles
V4-Pro est le premier choix si l’objectif est la qualité sur des demandes exigeantes : résolution de problèmes, écriture de code, analyse scientifique, rédaction structurée ou raisonnement logique. Sa fenêtre de contexte annoncée atteint 1 million de tokens, avec une sortie pouvant aller jusqu’à 384 000 tokens. Ces chiffres changent la donne pour les usages longs, comme la revue de documentation, l’audit de code, la synthèse de plusieurs fichiers ou la construction d’un plan détaillé sur un projet complexe.
V4-Flash : la variante à surveiller pour les agents
DeepSeek V4-Flash est présenté comme une version distincte, plus rapide ou différente dans son usage, avec une API publique en bêta. L’annonce met aussi en avant des capacités d’agent plus avancées. Cela intéresse surtout les développeurs et les équipes qui veulent faire exécuter plusieurs étapes à un modèle : lire une consigne, appeler un outil, corriger un résultat, relancer une action, puis produire une réponse exploitable.
V4-Pro, V4-Flash, R1 : quel modèle pour quel usage ?
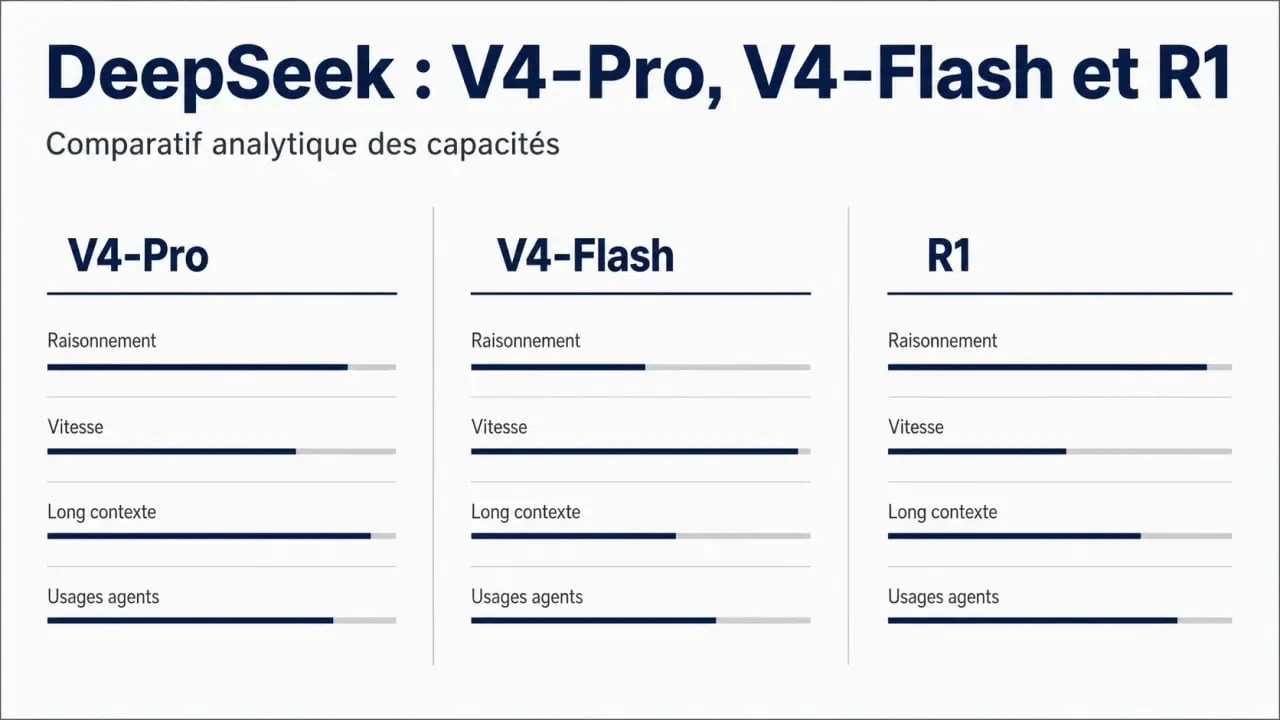
Le bon choix dépend moins du nom du modèle que du scénario. Un utilisateur qui teste une idée de temps en temps n’a pas les mêmes besoins qu’une équipe qui branche une API dans un outil interne. De même, un développeur qui cherche de l’agentic coding ne vise pas le même résultat qu’un rédacteur qui analyse un corpus documentaire.
| Modèle ou famille | Positionnement | Usages les plus pertinents | Point d’attention |
|---|---|---|---|
| DeepSeek V4-Pro | Modèle phare de la génération V4 | Raisonnement logique, code, mathématiques, analyse longue, recherche | À privilégier quand la qualité prime sur la vitesse |
| DeepSeek V4-Flash | Version distincte, API publique en bêta | Agents, workflows multi-étapes, automatisations, intégrations | Statut bêta à prendre en compte en production |
| DeepSeek R1 | Référence souvent citée pour le raisonnement | Problèmes logiques, explications étape par étape, calculs complexes | À comparer selon la tâche exacte, pas seulement sur réputation |
| Modèles propriétaires | Écosystèmes matures et intégrations nombreuses | Productivité, outils d’entreprise, assistants généralistes, copilotes | Coût, verrouillage fournisseur et limites de contexte à vérifier |
Le vrai pivot dans ce choix, c’est la manière dont l’intelligence intervient. Soit elle répond en une fois, soit elle s’insère dans une chaîne d’actions. Si vous demandez une synthèse de 80 pages, V4-Pro et son long contexte deviennent stratégiques. Si vous voulez qu’un modèle inspecte un dépôt, propose une modification, relise les erreurs puis recommence, V4-Flash peut être plus pertinent grâce à son orientation agentique. Cette distinction évite une erreur fréquente : choisir le plus gros modèle alors que le besoin réel concerne surtout l’orchestration, la latence ou la capacité à dialoguer avec des outils.
Les usages où DeepSeek V4 peut vraiment faire la différence
DeepSeek V4 est particulièrement attendu sur les tâches qui dépassent la simple conversation. Son intérêt augmente dès que la demande implique beaucoup de contexte, plusieurs contraintes ou une logique en plusieurs étapes. C’est là que ses capacités annoncées deviennent utiles au quotidien.
Guide d’intégration de l’API DeepSeek V4 et ses tarifs · Découvrez la documentation pour intégrer l’API DeepSeek V4 compatible OpenAI, comparer les modèles Pro et Flash, et consulter les tarifs par token.
Code, débogage et agentic coding
Pour le développement, DeepSeek V4 peut servir à expliquer une base de code, générer des fonctions, proposer des tests, repérer des incohérences ou aider à une migration technique. Dans un environnement comme VS Code, Cursor, GitHub Copilot ou un outil interne, l’enjeu n’est pas seulement de produire du code. Il faut comprendre l’architecture, respecter les conventions du projet et éviter les corrections superficielles.
Pour obtenir de meilleurs résultats, il faut fournir le langage, le framework, la version ciblée, les fichiers concernés, les erreurs exactes et le résultat attendu. Sur une tâche agentique, mieux vaut demander au modèle de découper son action : diagnostic, hypothèses, modification proposée, vérification, puis résumé des risques. Cette méthode réduit les réponses trop vagues et aide à garder un fil clair dans les tâches longues.
Mathématiques, sciences et recherche
Les capacités annoncées en mathématiques, sciences STEM et raisonnement logique placent DeepSeek V4 dans une catégorie utile pour les analyses exigeantes. Il peut aider à reformuler un problème, comparer plusieurs méthodes, vérifier une démonstration ou produire une explication pédagogique. Cela ne remplace pas une validation humaine, surtout dans un contexte académique ou professionnel, mais accélère la phase d’exploration.
Documents longs, synthèses et rédaction structurée
La fenêtre de contexte d’un million de tokens change l’échelle des usages possibles. Elle permet d’envisager l’analyse de documents volumineux, de spécifications produit, de contrats, de notes de recherche ou de corpus éditoriaux. La sortie jusqu’à 384 000 tokens peut aussi intéresser les travaux longs : rapports, plans détaillés, documentation technique ou contenus créatifs très structurés.
Dans ce type de tâche, le modèle n’est pas seulement jugé sur la réponse finale. Il compte aussi sur sa capacité à garder la cohérence d’un bout à l’autre, à suivre des consignes multiples et à traiter les répétitions sans perdre le fil. C’est précisément là que le long contexte devient un argument fort.
Accès gratuit, API et coût réel : ce qu’il faut vérifier
DeepSeek V4-Pro est présenté comme disponible gratuitement et sans inscription sur le site francophone, ce qui réduit fortement la friction pour tester le modèle. Pour un premier essai, c’est suffisant : vous pouvez comparer la qualité des réponses sur vos propres prompts, mesurer la cohérence des raisonnements et voir si le style vous convient.
Pour un usage professionnel, l’API devient centrale. DeepSeek V4-Flash dispose d’une API publique en bêta, ce qui ouvre la porte à des intégrations dans des workflows, des outils métier ou des assistants internes. Mais le mot bêta doit être pris au sérieux : disponibilité, stabilité, limites de débit, changements de comportement et documentation peuvent évoluer.
Sur le coût, il faut éviter les conclusions trop rapides. Un modèle peut paraître moins cher à l’appel, mais devenir coûteux si les prompts sont très longs, si l’on exploite massivement le contexte d’un million de tokens ou si l’agent relance de nombreuses étapes. Le bon calcul consiste à tester un scénario réel : un dossier complet, un dépôt de code, un workflow d’assistance client ou une chaîne d’analyse, puis à mesurer le nombre d’appels, la taille des entrées, la taille des sorties et le taux de correction humaine nécessaire.
DeepSeek V4 face aux modèles propriétaires : promesse forte, test indispensable
DeepSeek se positionne naturellement face aux modèles propriétaires les plus puissants, notamment ceux utilisés dans les assistants généralistes, les copilotes de code et les plateformes de productivité. L’argument est clair : proposer des performances élevées, un très long contexte, un accès facilité et un rapport coût-performance potentiellement attractif.
La comparaison ne doit pas se limiter aux benchmarks. En usage réel, un modèle se juge sur sa régularité, sa capacité à suivre des consignes longues, sa précision linguistique, son comportement avec des outils, sa gestion des erreurs et la qualité de son écosystème. Les modèles propriétaires conservent souvent un avantage sur l’intégration, la documentation, les connecteurs, la sécurité entreprise ou les habitudes déjà installées chez les équipes.
DeepSeek V4 devient particulièrement intéressant si vous cherchez une alternative à tester sérieusement, si vos tâches exploitent le long contexte, ou si vous voulez diversifier vos fournisseurs d’IA. Pour une décision rationnelle, préparez un jeu de prompts représentatif : un cas de code, un cas de raisonnement, un cas documentaire, un cas multilingue et un cas agentique. Comparez ensuite non seulement la meilleure réponse obtenue, mais aussi la stabilité des résultats sur plusieurs essais.
En résumé, DeepSeek V4-Pro attire par sa puissance annoncée, ses 1 600 milliards de paramètres, ses 49 milliards actifs et son contexte massif. V4-Flash, lui, mérite l’attention pour les workflows multi-étapes et l’API en bêta. Le bon réflexe n’est donc pas de demander si DeepSeek V4 est “meilleur” dans l’absolu, mais s’il est meilleur pour votre charge de travail, votre budget, vos outils et votre tolérance au risque.
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
- Application productivité : 6 outils pour reprendre le contrôle de vos journées - 14 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 1minAI : avis sur l’offre lifetime, les crédits et la confidentialité
 Intelligence artificielle Free : accéder à Le Chat Pro de Mistral AI, gratuité réelle et limites à connaître
 DeepSeek V4-Pro ou V4-Flash : quel modèle choisir pour le code, le raisonnement et les longs contextes ?
 Intelligence artificielle en santé : usages concrets, bénéfices réels et cadre européen