DeepSeek V4-Pro ou V4-Flash : quel modèle choisir pour le code, le raisonnement et les longs contextes ?
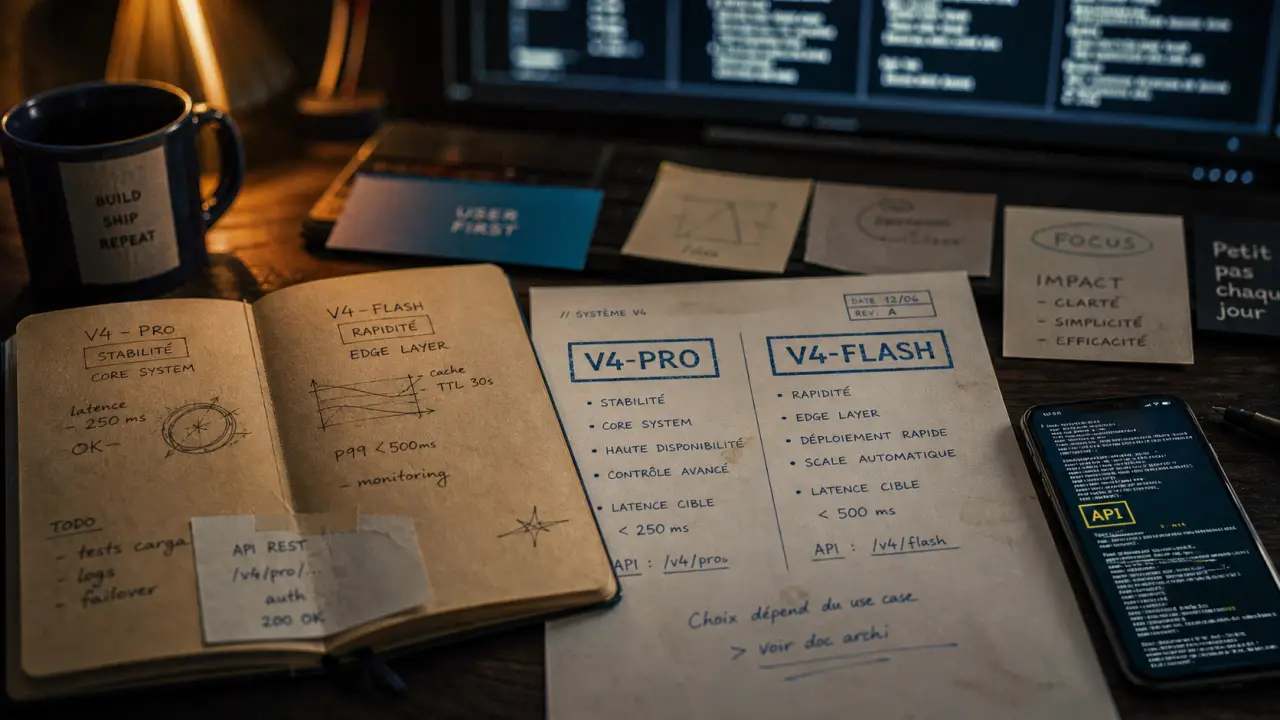
DeepSeek 4 désigne la génération V4 des modèles DeepSeek, avec deux noms qui reviennent souvent : DeepSeek V4-Pro et DeepSeek V4-Flash. Le premier cible les tâches exigeantes de raisonnement, de code, de mathématiques et d’analyse longue. Le second vise un usage plus direct, notamment via l’API DeepSeek-V4-Flash lancée en bêta publique.
Pour faire le bon choix, il ne suffit pas de demander quel modèle est le plus puissant. La vraie question est simple : avez-vous besoin d’un raisonnement profond, d’une grande fenêtre de contexte, d’une sortie très longue, ou d’un assistant rapide pour expérimenter, coder, résumer et structurer vos idées ?
Ce que recouvre vraiment DeepSeek 4
DeepSeek 4 n’est pas un produit unique. C’est une génération de modèles qui comprend au moins deux variantes importantes, DeepSeek V4-Pro et DeepSeek V4-Flash. Elles partagent le même socle technique, mais elles ne répondent pas au même besoin.
Quiz sur DeepSeek 4
V4-Pro, la version orientée raisonnement avancé
DeepSeek V4-Pro est présenté comme le modèle phare de la génération V4. Son intérêt principal se situe dans les tâches complexes : raisonnement logique, programmation avancée, calculs mathématiques, recherche approfondie, analyses structurées ou workflows multi-étapes. C’est le modèle à privilégier lorsqu’une réponse rapide ne suffit pas et qu’il faut garder une chaîne de raisonnement cohérente.
Ses chiffres donnent une idée claire de son positionnement : 1 600 milliards de paramètres, avec 49 milliards de paramètres actifs grâce à une architecture Mixture-of-Experts. Cette approche mobilise seulement une partie spécialisée du modèle selon la tâche, au lieu d’activer l’ensemble à chaque requête.
V4-Flash, la version plus accessible et expérimentale
DeepSeek V4-Flash s’inscrit davantage dans une logique d’accès pratique. L’API DeepSeek-V4-Flash est lancée en bêta publique, tandis que V4-Pro est indiqué comme inchangé pour l’instant. Pour un utilisateur qui veut tester DeepSeek, l’intégrer à un outil ou comparer des réponses sans entrer immédiatement dans une configuration lourde, Flash peut être le point d’entrée le plus naturel.
Il ne faut toutefois pas réduire V4-Flash à une version allégée. Son intérêt est différent : il sert à explorer, prototyper, automatiser certaines tâches et construire des usages avant de réserver V4-Pro aux demandes les plus difficiles.
Les capacités techniques qui font la différence
La génération DeepSeek 4 se distingue surtout par trois dimensions : l’architecture, la taille de contexte et la capacité de sortie. Ces éléments comptent beaucoup, car ils déterminent ce que le modèle peut absorber, traiter et restituer sans perdre le fil.
Guide complet pour intégrer l’API DeepSeek V4 · Accédez à la documentation technique officielle pour configurer, authentifier et optimiser vos appels aux modèles DeepSeek Pro et Flash.
Architecture Mixture-of-Experts : puissance et efficience
L’architecture Mixture-of-Experts, souvent abrégée MoE, repose sur une idée simple : tous les paramètres du modèle ne sont pas mobilisés pour chaque réponse. DeepSeek V4-Pro compte 1 600 milliards de paramètres, mais seuls 49 milliards actifs sont utilisés selon la requête. Cela permet de combiner une très grande capacité globale avec une activation plus ciblée.
Pour l’utilisateur, l’intérêt est concret : le modèle peut mieux adapter son raisonnement à des domaines variés, qu’il s’agisse d’un problème de code, d’une démonstration mathématique, d’une analyse documentaire ou d’une tâche agentique avec plusieurs étapes.
Un million de tokens de contexte pour les longs dossiers
La fenêtre de contexte d’un million de tokens est l’un des points les plus marquants. En pratique, cela signifie que le modèle peut travailler avec un volume très important d’informations dans une même interaction : documents longs, spécifications techniques, corpus de recherche, bases de connaissances internes ou suites d’échanges complexes.
La capacité de sortie annoncée, jusqu’à 384 000 tokens, ouvre aussi des usages rares : rédaction de rapports très longs, génération de documentation structurée, synthèse de dossiers volumineux ou production de plans détaillés sur plusieurs niveaux. Cette puissance n’exonère pas de cadrer la demande : plus le volume est grand, plus il faut guider le modèle.
Il existe un seuil souvent négligé : le moment où une requête cesse d’être une simple question et devient un véritable dossier de travail. Avant ce seuil, un prompt court peut suffire. Après, il faut penser comme un chef de projet : définir l’objectif, hiérarchiser les documents, préciser les critères de réussite, signaler ce qui est prioritaire et ce qui ne l’est pas. Avec une fenêtre de contexte aussi large, le risque n’est pas seulement de manquer d’information, mais d’en fournir trop sans ordre. La qualité dépend alors de la signalétique intellectuelle que vous donnez au modèle.
V4-Pro ou V4-Flash : quel modèle choisir selon l’usage ?
Le bon choix dépend moins du prestige du modèle que du type de tâche. V4-Pro convient lorsque le coût cognitif est élevé : plusieurs contraintes à tenir ensemble, raisonnement long, dépendances entre étapes, vérification logique. V4-Flash est plus pertinent pour tester, produire vite, automatiser des tâches répétables ou intégrer DeepSeek dans un flux via API.
| Critère | DeepSeek V4-Pro | DeepSeek V4-Flash |
|---|---|---|
| Positionnement | Modèle phare V4, orienté raisonnement avancé | Version accessible, API en bêta publique |
| Meilleurs usages | Code complexe, mathématiques, recherche, analyse longue | Tests, intégrations, automatisations, prototypage |
| Type de demande | Tâches multi-étapes et agentic coding | Questions claires, traitements rapides, itérations |
| Choix recommandé | Quand l’exactitude du raisonnement prime | Quand la rapidité d’expérimentation prime |
Quand privilégier V4-Pro
V4-Pro devient intéressant dès que la réponse doit être robuste, argumentée et vérifiable. Par exemple : analyser un grand nombre de fichiers, générer une architecture logicielle, résoudre un problème mathématique en plusieurs étapes, comparer des hypothèses de recherche ou orchestrer un workflow avec sous-agents et utilisation d’outils.
Il est aussi plus adapté lorsqu’une erreur coûte cher en temps : refactorisation complexe, analyse stratégique, extraction de contradictions dans un long document, préparation d’un protocole ou aide à la décision technique.
Quand commencer avec V4-Flash
V4-Flash est souvent le bon choix pour démarrer. Il permet de vérifier si DeepSeek correspond à votre manière de travailler, de tester des prompts, de construire une intégration API et d’évaluer la qualité des réponses sur des cas simples à intermédiaires. Pour un usage quotidien, il peut suffire à résumer, reformuler, classifier, extraire des informations ou produire des brouillons structurés.
Une bonne méthode consiste à travailler d’abord avec Flash, puis à transférer vers V4-Pro les tâches qui résistent : celles où le modèle doit raisonner longtemps, comparer plusieurs contraintes ou maintenir une cohérence sur un volume très important.
Cas d’usage concrets : code, recherche, mathématiques et agents
DeepSeek 4 attire surtout parce qu’il couvre des usages où les modèles généralistes montrent vite leurs limites. Sa valeur apparaît quand la tâche demande plus qu’une formulation élégante : il faut calculer, vérifier, enchaîner des étapes et tenir compte d’un contexte dense.
Programmation avancée et agentic coding
En développement, DeepSeek V4-Pro peut aider à comprendre une base de code, générer des tests, expliquer une erreur, proposer une architecture ou découper une fonctionnalité en tâches. L’angle agentic coding est particulièrement important : le modèle ne se contente pas de produire du code, il peut participer à un workflow multi-étapes, avec planification, usage d’outils et intervention de sous-agents.
Pour obtenir de meilleurs résultats, il faut fournir le langage, le framework, les contraintes de performance, les fichiers concernés et le résultat attendu. Une demande comme “corrige ce bug” sera moins efficace qu’une requête qui décrit le comportement observé, le comportement attendu, les logs et les pistes déjà testées.
Recherche, analyse et mathématiques
Pour la recherche et l’analyse, la grande fenêtre de contexte permet de soumettre des documents longs et de demander une synthèse structurée, une comparaison de positions, une extraction d’arguments ou une mise en évidence des zones d’incertitude. En mathématiques, le raisonnement est utile pour détailler les étapes plutôt que donner uniquement un résultat final.
Il reste recommandé de relire les sorties, surtout sur les sujets sensibles ou les calculs déterminants. Un modèle puissant peut structurer un raisonnement et accélérer l’exploration, mais l’utilisateur garde le rôle de validation.
Accès, gratuité et bonnes pratiques de prompting
L’intention autour de “DeepSeek 4” est aussi très pratique : beaucoup d’utilisateurs veulent savoir où essayer le modèle, s’il existe un accès gratuit, s’il faut créer un compte et comment passer par l’API. Les pages officielles de DeepSeek et les pages de modèles restent les points de référence à privilégier pour éviter les copies, interfaces peu fiables ou promesses excessives.
Des accès gratuits et sans inscription sont mis en avant dans l’écosystème DeepSeek, mais les conditions peuvent dépendre de l’interface utilisée, des limites de requêtes et de la disponibilité des modèles. Pour un usage professionnel, l’accès API est généralement plus pertinent, en particulier avec DeepSeek-V4-Flash en bêta publique.
Des prompts courts, mais mieux cadrés
La qualité des réponses dépend fortement de la formulation. Les meilleurs résultats viennent rarement d’une phrase vague. Il vaut mieux indiquer le rôle attendu, le contexte, le format de sortie, les contraintes et les critères de réussite.
- Formulez une demande précise : objectif, audience, niveau de détail et livrable attendu.
- Découpez les tâches complexes : diagnostic, plan, exécution, vérification.
- Ajoutez le contexte utile : données, fichiers, hypothèses, limites connues.
- Demandez une justification quand le raisonnement compte, notamment en code, mathématiques ou analyse.
- Itérez : une première réponse sert souvent à clarifier le problème avant la version finale.
En résumé, DeepSeek 4 se comprend mieux comme un ensemble d’outils que comme un simple chatbot. V4-Pro s’adresse aux tâches profondes où le raisonnement et le contexte font la différence. V4-Flash facilite l’accès, les tests et l’intégration. Le meilleur choix consiste souvent à utiliser les deux intelligemment : Flash pour explorer et automatiser, Pro pour résoudre ce qui exige une vraie profondeur de traitement.
- Cloud computing engineer : concevoir des infrastructures fiables, évolutives et maîtrisées - 16 septembre 2026
- Logiciel de productivité : comment automatiser vos tâches et gagner du temps chaque jour ? - 15 septembre 2026
- Application productivité : 6 outils pour reprendre le contrôle de vos journées - 14 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Midjourney essai gratuit : 25 images, accès variable et alternatives sans payer
 Logiciel paie automatisé : gagner du temps sur les variables, les contrôles et l’archivage
 CRM avec intelligence artificielle : automatiser, scorer, prévoir et mesurer le ROI
 Intelligence artificielle en banque : usages concrets, gains mesurables et risques à maîtriser