GPU cloud computing : accélérer l’IA, le rendu 3D et le HPC sans acheter de cartes graphiques
Le GPU cloud computing consiste à louer de la puissance GPU dans le cloud pour exécuter des charges de travail intensives sans acheter ni maintenir les cartes graphiques en interne. Cette approche sert autant à l’IA qu’au machine learning, au rendu 3D, à la simulation scientifique ou à l’analytics à grande échelle. L’objectif est simple : disposer de la bonne capacité au bon moment, avec un coût maîtrisé et une intégration fiable dans l’existant.
Comprendre le GPU cloud sans le confondre avec un simple serveur puissant
Un GPU cloud est une ressource de calcul graphique accessible à la demande sous forme d’instance, de machine virtuelle ou de nœud spécialisé. Contrairement à un serveur classique centré sur le CPU, il exploite des processeurs graphiques capables d’exécuter un très grand nombre d’opérations en parallèle. Cette architecture devient utile dès qu’un même calcul doit être répété sur de gros volumes de données : matrices de modèles IA, images, vidéos, simulations physiques, signaux ou jeux de données analytiques.
Comprendre le GPU Cloud
CPU, GPU et parallélisme : la différence qui change tout
Le CPU reste excellent pour les tâches séquentielles, la logique applicative, les bases de données ou les services web généralistes. Le GPU, lui, est conçu pour le parallélisme massif. Dans un pipeline de machine learning, il peut accélérer l’entraînement d’un modèle en traitant en même temps de nombreuses opérations mathématiques. Dans un studio 3D, il réduit les temps de rendu. Dans un environnement HPC, il accélère des simulations trop lentes sur une architecture uniquement CPU.
Virtualisation GPU et instances à la demande
Dans le cloud, les fournisseurs mettent à disposition des instances GPU prêtes à être provisionnées via un dashboard, une API ou des outils d’automatisation. Selon les offres, la virtualisation GPU peut reposer sur des mécanismes comme KVM, l’isolation des workloads ou le PCI Passthrough pour exposer plus directement le matériel à la machine virtuelle. L’utilisateur choisit une configuration, installe ou utilise les pilotes nécessaires, connecte le stockage et le réseau, puis lance son workload.
La logique reste modulaire : certaines offres OVHcloud proposent 1–4 GPUs par instance, tandis que Google Cloud indique des configurations allant jusqu’à huit GPU par instance. Cette élasticité permet de tester à petite échelle, d’augmenter la capacité pendant une phase d’entraînement, puis de réduire ou supprimer les ressources une fois le pic passé.
Pourquoi choisir le cloud GPU plutôt qu’un GPU physique
Le principal avantage du cloud GPU est d’éviter un investissement matériel lourd avant d’avoir validé le besoin. Acheter des cartes haut de gamme, prévoir l’alimentation, le refroidissement, la maintenance, les garanties et l’espace en datacenter peut se justifier pour une charge stable et prévisible. Mais pour un projet en phase d’expérimentation, une campagne de rendu ponctuelle ou des entraînements IA irréguliers, la location à l’usage offre une souplesse bien plus confortable.
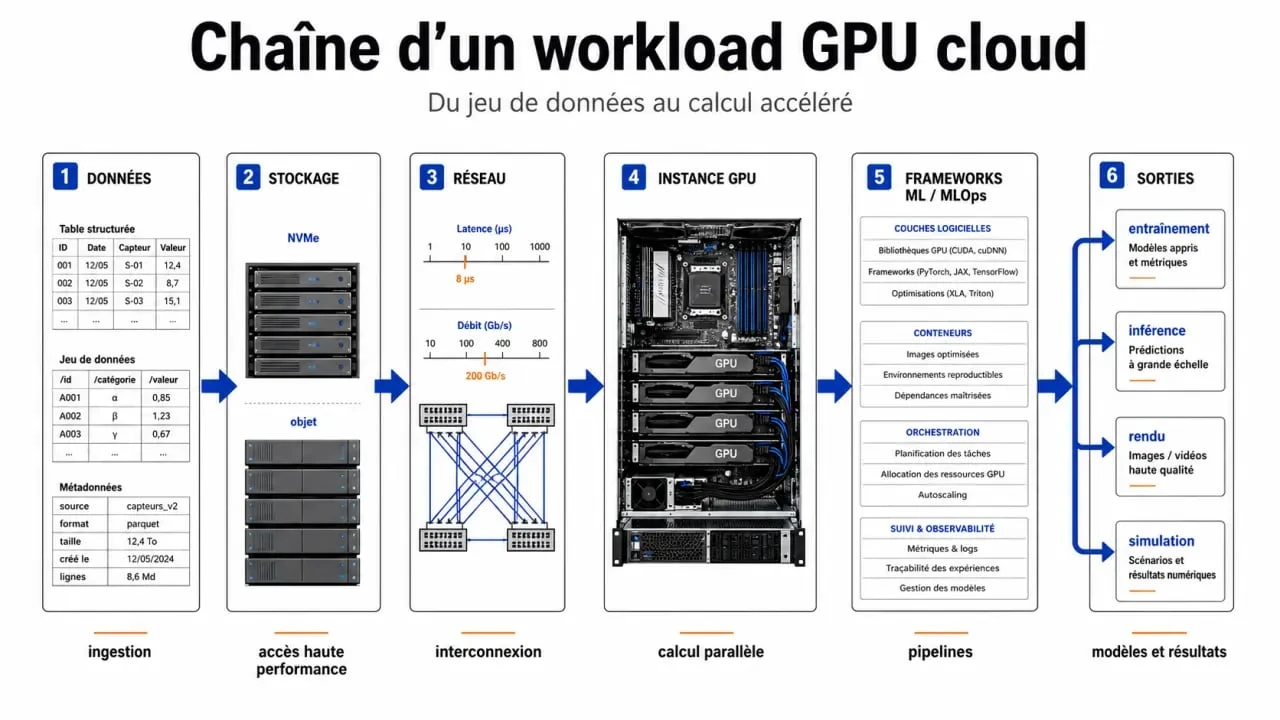
| Option | Points forts | Limites à surveiller |
|---|---|---|
| GPU cloud | Déploiement rapide, scalabilité, paiement à l’usage, maintenance externalisée | Coûts variables, dépendance réseau, choix d’instance à optimiser |
| GPU physique on-premise | Contrôle matériel, coûts prévisibles si usage continu, proximité des données internes | Achat initial, maintenance, obsolescence, capacité moins flexible |
| CPU cloud classique | Polyvalence, simplicité, adapté aux applications généralistes | Moins efficace pour IA, rendu, simulation et calcul massivement parallèle |
Le coût ne se limite pas au prix de l’instance
Comparer les prix horaires ne suffit pas. Il faut raisonner en coût total de possession : temps de calcul économisé, stockage haute performance, transferts de données, réseau privé ou public, support, supervision, licences éventuelles et temps passé par les équipes à maintenir l’infrastructure. Google Cloud propose une facturation à la seconde sur certains services, ce qui peut être intéressant pour des workloads courts ou automatisés. À l’inverse, une instance laissée active après un test peut vite transformer un avantage économique en dépense inutile.
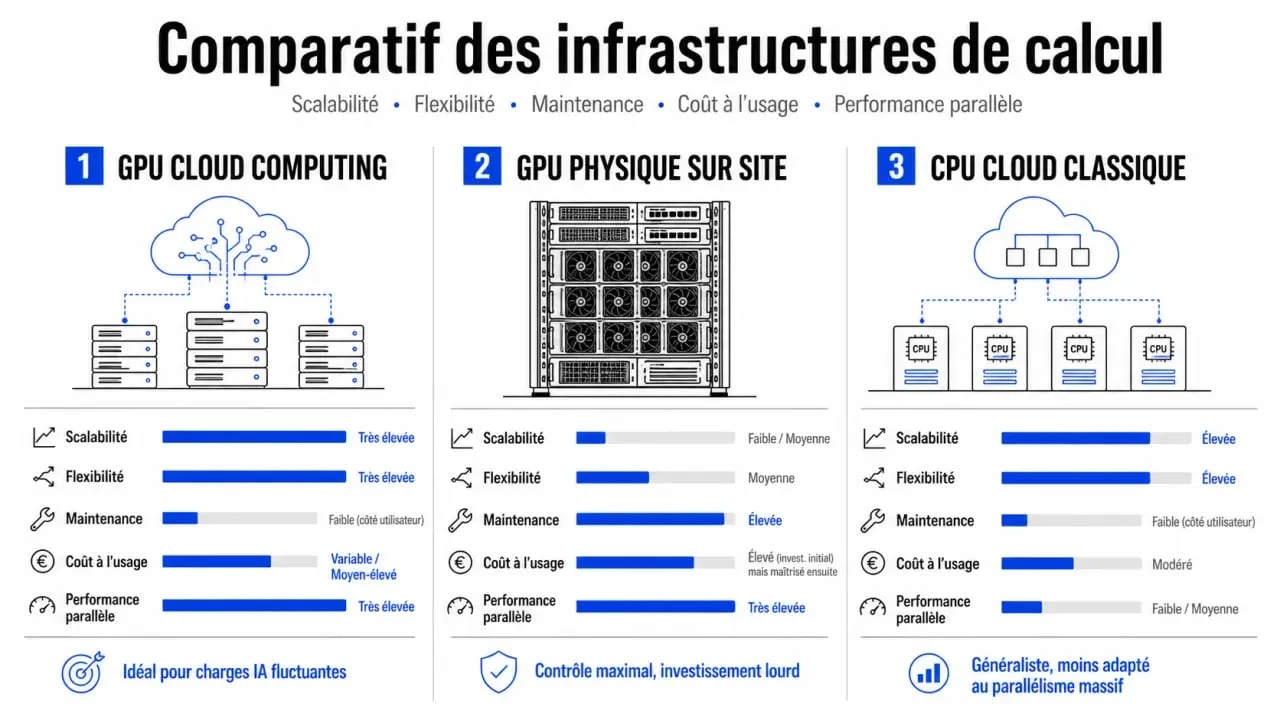
Un bon dimensionnement ressemble à une architecture en couche : la carte GPU n’est qu’un niveau de l’ensemble. En dessous, il y a le stockage, souvent décisif si les datasets sont volumineux ; autour, le réseau, qui conditionne les transferts et la latence ; au-dessus, les frameworks ML, les conteneurs, l’orchestration et le monitoring. Beaucoup d’équipes choisissent d’abord le GPU le plus puissant, puis découvrent que le goulet d’étranglement vient d’un disque trop lent, d’une bande passante insuffisante ou d’un pipeline de données mal préparé. Penser par strates évite de payer pour une puissance de calcul que le reste de l’architecture n’arrive pas à alimenter.
Les cas d’usage où le GPU cloud apporte le plus de valeur
Le GPU cloud computing devient pertinent lorsque la vitesse de calcul influence directement la faisabilité du projet, le délai de mise en production ou la qualité du résultat. Il n’est pas nécessaire pour tous les workloads, mais il peut devenir décisif dès que les volumes, la complexité ou les délais dépassent les capacités d’une infrastructure classique.
IA, machine learning et inférence
L’entraînement de modèles IA et ML est l’un des usages les plus courants. Les grands modèles de langage, la vision par ordinateur, la recommandation ou le traitement du langage naturel exploitent fortement le calcul parallèle. NVIDIA cite notamment un cas Writer impliquant 17 large language models et 70 billion parameters. Dans un autre cas, Perplexity a obtenu une réduction du temps d’entraînement jusqu’à 40%, tout en supportant 10,000 concurrent users et 100,000 queries per hour pour l’inférence.
L’inférence bénéficie aussi du GPU lorsque les réponses doivent rester rapides et nombreuses. Des optimisations logicielles comme TensorRT ou des services d’inférence spécialisés peuvent aider à réduire la latence, mais le choix du GPU, de la mémoire et du réseau reste central.
Rendu 3D, vidéo et workloads graphiques
Les studios d’animation, agences créatives, éditeurs de jeux et équipes de visualisation industrielle utilisent le cloud GPU pour absorber des pics de rendu sans acheter une ferme dédiée. Beamr est cité avec une efficacité améliorée de 30% dans un contexte vidéo. Pour les équipes créatives, l’intérêt est concret : livrer plus vite, multiplier les variantes visuelles et conserver une infrastructure légère entre deux productions.
HPC, simulation et analytics
Le calcul haute performance couvre les simulations physiques, la modélisation scientifique, la finance quantitative, la recherche pharmaceutique ou l’optimisation industrielle. NVIDIA cite Encina avec une simulation 506X faster, et A-Alpha Bio avec une inférence 12X faster et une hausse 10X des prédictions. Ces ordres de grandeur montrent pourquoi le GPU cloud peut devenir un accélérateur de recherche, à condition que les données, le code et les dépendances suivent.
Critères de choix : performance, intégration, sécurité et SLA
Choisir une offre GPU cloud ne consiste pas seulement à sélectionner la carte la plus récente. Une bonne décision commence par le workload : entraînement long, inférence temps réel, rendu ponctuel, notebook d’expérimentation, cluster Kubernetes, pipeline Spark ou traitement Dataflow. Chaque scénario a ses contraintes propres en mémoire GPU, bande passante, latence, stockage et orchestration.
Les critères techniques à comparer
- Mémoire GPU : essentielle pour les grands modèles, les batchs volumineux et les scènes 3D complexes.
- Nombre de GPU par instance : utile pour l’entraînement distribué, mais seulement si le logiciel sait en tirer parti.
- Réseau : certaines offres OVHcloud mentionnent jusqu’à 25 Gbps sur réseau public ou privé, un point important pour les datasets lourds.
- Stockage : NVMe, stockage objet ou volumes persistants doivent correspondre au rythme de lecture et d’écriture.
- Écosystème : intégration avec Compute Engine, Google Kubernetes Engine, Managed Service for Apache Spark, Dataflow, conteneurs, MLOps ou outils d’automatisation.
- Support et disponibilité : OVHcloud met en avant un SLA de 99.99% monthly availability sur certaines offres, utile pour des workloads critiques.
Sécurité et conformité ne sont pas des détails
Les environnements GPU cloud doivent garantir l’isolation des workloads, la gestion des accès, le chiffrement des données, les mises à jour et la traçabilité. Pour une DSI, ces éléments comptent autant que la performance brute. Il faut vérifier où sont hébergées les données, quelles certifications ou garanties sont proposées, comment les snapshots sont protégés et comment les accès API sont contrôlés. La conformité peut aussi orienter le choix entre cloud public, cloud privé, approche hybride ou stratégie multi-cloud.
Réussir le déploiement sans surpayer la puissance GPU
La meilleure approche consiste à commencer par un benchmark réaliste. Un petit jeu de données ou un modèle simplifié peut donner une tendance, mais il ne reflète pas toujours le comportement en production. Il faut tester avec des volumes proches du réel, mesurer l’utilisation GPU, CPU, mémoire, disque et réseau, puis ajuster l’instance. Une carte très puissante mais utilisée à 25% n’est pas un bon investissement, même louée à la demande.
Bonnes pratiques de mise en œuvre
- Définir le type de workload : entraînement, inférence, rendu, simulation ou analytics.
- Choisir une instance minimale viable, puis monter en gamme selon les mesures.
- Automatiser l’arrêt des ressources inutilisées pour éviter les coûts dormants.
- Surveiller la latence, le débit, la mémoire GPU et les temps d’attente I/O.
- Documenter les images, pilotes, versions CUDA, dépendances et scripts de déploiement.
- Prévoir une stratégie de sauvegarde, de reprise et de contrôle des accès.
Le GPU cloud computing est donc moins une simple location de cartes graphiques qu’un modèle opérationnel : provisionner vite, scaler quand la charge l’exige, mesurer en continu et arbitrer entre performance, coût, sécurité et souveraineté. Pour une startup IA, un laboratoire, une PME industrielle ou une DSI, la bonne offre est celle qui accélère le workload sans complexifier inutilement l’architecture. Le vrai gain vient de cet équilibre, pas seulement du nombre de GPU affiché sur la fiche technique.

- La sécurité des données protège les accès utiles sans multiplier les fuites - 17 septembre 2026
- Cybersécurité en entreprise : 82 % des failles impliquent une erreur humaine - 13 septembre 2026
- Biais dans l’intelligence artificielle : données, modèles, usages, les trois angles morts à surveiller - 3 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 DeepSeek AI : accès officiels, modèles et bons réflexes avant de vous connecter
 Miniature YouTube IA : 3 leviers pour booster votre CTR sans compétences en design
 Gagner du temps sans multiplier les applications, le vrai rôle des outils de productivité
 Vidéo, gaming, eKYC : le cloud de Tencent se distingue par ses usages métier