Biais dans l’intelligence artificielle : données, modèles, usages, les trois angles morts à surveiller
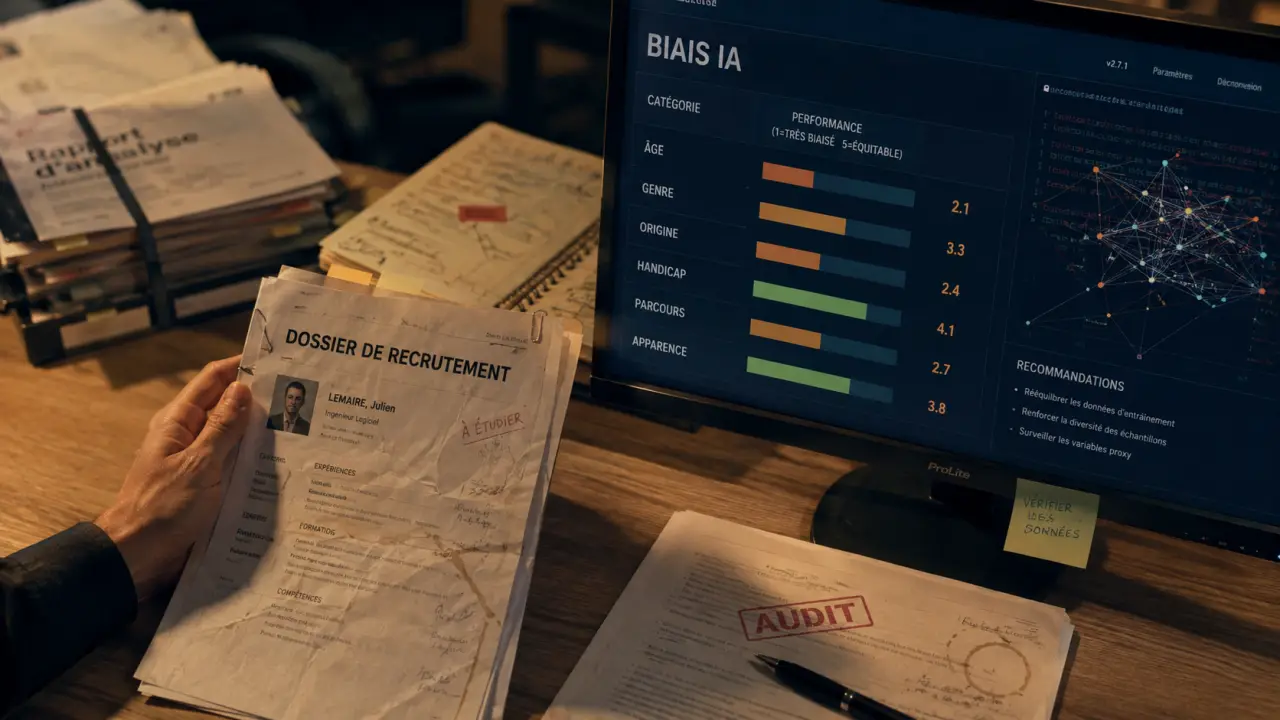
Un système d’intelligence artificielle peut sembler neutre parce qu’il calcule, classe ou prédit à partir de données. En pratique, il peut reproduire des déséquilibres déjà présents dans le monde réel, amplifier des stéréotypes ou privilégier certains profils sans que cela soit immédiatement visible. Comprendre les biais de l’IA n’est donc pas un sujet réservé aux data scientists : c’est une condition pour utiliser ces outils avec discernement, notamment dans le recrutement, la santé, le crédit, l’éducation ou la relation client.
Ce qu’on appelle vraiment un biais dans l’IA
Un biais en intelligence artificielle désigne une distorsion systématique dans les résultats produits par un modèle. Cette distorsion ne vient pas forcément d’une intention discriminatoire. Elle peut naître d’un jeu de données incomplet, d’un objectif mal formulé, d’un choix technique discutable ou d’une interprétation humaine trop confiante.
Quiz sur les biais de l’IA
Par exemple, si un outil de tri de CV a été entraîné sur des profils historiquement recrutés dans une entreprise peu diverse, il risque de considérer ces profils comme la norme. Le modèle n’a pas d’opinion, mais il apprend une régularité passée et peut la transformer en critère de décision pour l’avenir. Dans ce cas, le problème ne vient pas d’un cas isolé. Il vient de la manière dont le système généralise ce qu’il a vu.
Une erreur qui se répète vaut plus qu’un accident isolé
Il ne faut pas confondre biais et simple erreur ponctuelle. Un modèle peut se tromper sur un cas particulier sans être biaisé. Le problème apparaît lorsque l’erreur suit une direction régulière : un groupe est moins bien reconnu par un système de reconnaissance faciale, certains accents sont moins bien compris par une reconnaissance vocale, ou des quartiers sont associés plus souvent à un risque financier élevé.
Le biais devient alors un risque opérationnel, juridique et éthique. Il peut affecter la qualité d’un service, la confiance des utilisateurs et la conformité d’une organisation, en particulier lorsque les décisions automatisées touchent l’accès à un emploi, un prêt, une assurance ou un soin.
D’où viennent les biais : données, modèles et décisions humaines
Les biais ne surgissent pas à la fin du projet. Ils peuvent entrer à chaque étape : collecte des données, annotation, entraînement, choix de l’algorithme, métriques de performance, déploiement et usage métier. Une IA biaisée est souvent le résultat d’une chaîne de petites décisions cohérentes en apparence, mais insuffisamment questionnées.
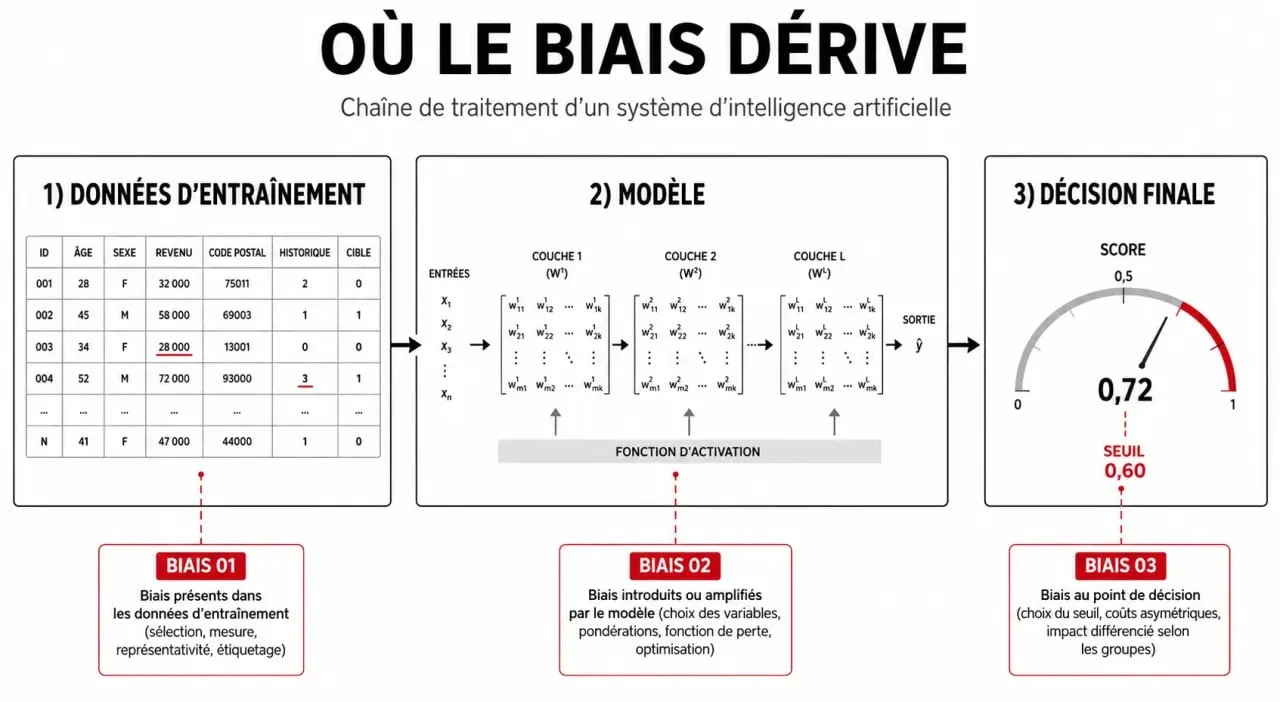
Les données d’entraînement : le premier miroir déformant
Les modèles apprennent à partir d’exemples. Si ces exemples ne représentent pas correctement la diversité des situations réelles, le résultat sera fragile. On parle notamment de biais de sélection lorsque certaines populations, langues, comportements ou contextes sont sous-représentés. Le modèle devient performant sur ce qu’il connaît bien, mais moins fiable sur ce qu’il a peu rencontré.
Deux techniques peuvent limiter ce risque : le suréchantillonnage, qui augmente la présence de catégories peu représentées, et le sous-échantillonnage, qui réduit le poids de catégories dominantes. Ces méthodes ne suffisent pas toujours, mais elles obligent à regarder la composition réelle des données plutôt que de supposer leur neutralité.
Les choix algorithmiques : optimiser n’est pas toujours équilibrer
Un modèle est généralement entraîné pour optimiser un objectif : précision, rapidité, taux de conversion, réduction du risque, similarité avec un comportement passé. Or une très bonne performance globale peut masquer une mauvaise performance sur un sous-groupe. Un outil peut afficher un taux d’exactitude satisfaisant en moyenne, tout en étant beaucoup moins fiable pour certaines catégories d’utilisateurs.
Des approches comme la régularisation ou les algorithmes adversariaux peuvent aider à réduire certaines dépendances indésirables entre variables sensibles et prédictions. Mais la technique ne remplace pas la question de départ : que veut-on optimiser, pour qui, et avec quelles conséquences ?
Les biais cognitifs : l’humain reste dans la boucle
Les biais de l’IA ne sont pas seulement techniques. Les équipes qui conçoivent, paramètrent ou utilisent un modèle peuvent elles-mêmes introduire des biais cognitifs. Le biais de confirmation pousse à retenir les résultats qui valident une intuition. Le biais d’automatisation conduit à faire trop confiance à la machine parce qu’elle paraît objective. Le biais d’ancrage peut enfermer l’analyse dans la première hypothèse formulée.
L’effet Dunning-Kruger et l’illusion de connaissance aggravent parfois le problème : un utilisateur pense comprendre le fonctionnement d’un système parce qu’il sait l’interroger, alors qu’il ne maîtrise ni ses limites, ni ses données, ni ses critères de décision.
Les formes de biais les plus fréquentes à reconnaître
Nommer les biais aide à les repérer plus tôt. Dans un projet d’IA, ils se combinent souvent : un biais de données peut rencontrer un biais d’usage, puis être renforcé par une mauvaise interprétation humaine.
Le plan d’action de la CNIL pour encadrer l’IA et les données · Découvrez comment la CNIL organise sa régulation de l’intelligence artificielle pour protéger les données personnelles tout en favorisant l’innovation.
| Type de biais | Ce qu’il provoque | Exemple concret |
|---|---|---|
| Biais de sélection | Une partie de la population est mal représentée | Un modèle RH entraîné surtout sur des parcours issus des mêmes écoles |
| Biais de confirmation | Les résultats sont utilisés pour valider une idée déjà présente | Une équipe ne teste que les scénarios qui confirment son choix initial |
| Biais du survivant | Seuls les cas de réussite sont analysés | Un modèle commercial apprend uniquement sur les clients conservés |
| Biais d’automatisation | La recommandation machine est acceptée sans recul | Un conseiller suit un score de risque sans examiner le dossier |
| Biais génératif | Les réponses produites répètent des stéréotypes ou associations dominantes | Une IA d’image associe certains métiers à un seul genre ou profil |
Un bon réflexe consiste à regarder l’horizon de décision du modèle : jusqu’où ses effets se propagent-ils ? Une recommandation de contenu peut sembler anodine à l’instant où elle est affichée, mais elle façonne peu à peu ce qu’un utilisateur voit, croit désirable ou considère normal. À l’inverse, un score de crédit ou de santé agit comme une ligne de crête : une petite variation peut faire basculer une personne d’un côté ou de l’autre d’une décision importante. Évaluer un biais, ce n’est donc pas seulement inspecter une sortie technique. C’est suivre sa trajectoire dans le temps, dans les usages et dans la vie réelle des personnes concernées.
Conséquences concrètes : quand le biais devient un risque
Les biais algorithmiques ont des effets très variables selon le domaine. Dans une application de divertissement, ils peuvent enfermer l’utilisateur dans une bulle de recommandations. Dans des secteurs sensibles, ils peuvent limiter l’accès à des droits, à des opportunités ou à des services essentiels.
Recrutement, crédit, santé : trois zones à haute vigilance
Dans le recrutement, un système biaisé peut privilégier des profils qui ressemblent aux salariés déjà en poste, au détriment de compétences différentes mais pertinentes. Le risque n’est pas seulement moral : l’entreprise se prive de talents et renforce une homogénéité qui appauvrit ses décisions.
Dans le crédit ou l’assurance, un modèle peut associer indirectement certaines variables à un risque plus élevé, même sans utiliser explicitement de données sensibles. Le code postal, l’historique professionnel ou certains comportements numériques peuvent devenir des proxys problématiques. En santé, un biais peut dégrader la qualité d’un diagnostic ou d’une priorisation si le modèle a été entraîné sur une population trop limitée.
IA générative : des stéréotypes plus fluides, donc plus difficiles à voir
Les IA génératives posent un défi particulier, car leurs biais se manifestent dans des textes, images, synthèses ou suggestions qui paraissent naturelles. Elles peuvent produire des contenus stéréotypés, invisibiliser certaines perspectives ou présenter une réponse incertaine avec beaucoup d’assurance.
C’est pourquoi l’évaluation ne doit pas se limiter à vérifier si la réponse est grammaticalement correcte ou convaincante. Il faut tester la diversité des formulations, la représentation des profils, la cohérence des réponses selon les langues et la capacité du système à signaler ses limites.
Réduire les biais : une méthode avant un outil
Il n’existe pas de bouton magique pour supprimer tous les biais. En revanche, une démarche structurée permet de les rendre visibles, mesurables et corrigibles. Elle combine gouvernance des données, tests, documentation, contrôle humain et amélioration continue.
Avant le déploiement : tester plus large que le cas moyen
Un modèle doit être évalué sur différents segments, pas seulement sur une performance globale. L’A/B testing peut aider à comparer plusieurs versions, mais il doit être complété par des tests ciblés sur des groupes ou situations à risque. Il est également utile de documenter les données utilisées, les exclusions, les limites connues et les choix de métriques.
- Vérifier la diversité et la fraîcheur des données d’entraînement.
- Mesurer les performances par sous-populations pertinentes.
- Identifier les variables qui peuvent servir de proxys sensibles.
- Faire relire les résultats par des profils métiers, juridiques et éthiques.
- Prévoir un mécanisme de contestation ou de révision humaine.
Après le déploiement : surveiller les dérives
Un modèle acceptable au lancement peut devenir biaisé si les usages changent, si la population évolue ou si les données d’entrée se dégradent. La surveillance doit donc être continue. Les retours utilisateurs, les audits réguliers et les alertes sur écarts de performance sont indispensables pour corriger rapidement le tir.
Le cadre réglementaire européen, avec l’IA Act, pousse aussi les organisations à mieux classer les risques, documenter les systèmes et renforcer la transparence. Au-delà de la conformité, l’enjeu est simple : une IA utile est une IA dont les limites sont connues, discutées et prises en compte dans la décision finale.
Réduire les biais, ce n’est pas chercher une intelligence artificielle parfaitement neutre. C’est construire des systèmes plus robustes, plus explicables et mieux gouvernés, capables d’aider la décision sans se substituer au jugement humain.

- La sécurité des données protège les accès utiles sans multiplier les fuites - 17 septembre 2026
- Cybersécurité en entreprise : 82 % des failles impliquent une erreur humaine - 13 septembre 2026
- Biais dans l’intelligence artificielle : données, modèles, usages, les trois angles morts à surveiller - 3 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Clé USB non reconnue, fichiers illisibles, formatage proposé : comment récupérer vos données sans aggraver la panne ?
 ChatGPT jailbreak 2025 : méthodes de contournement moins fiables, risques toujours élevés
 Cloud Computing : transformer votre infrastructure IT en moteur de croissance stratégique
 Pax Historia DeepSeek not working : modèle indisponible, rate limit ou fournisseur ?