DeepSeek gratuit ou payant : le chat ne coûte rien, l’API facture chaque token
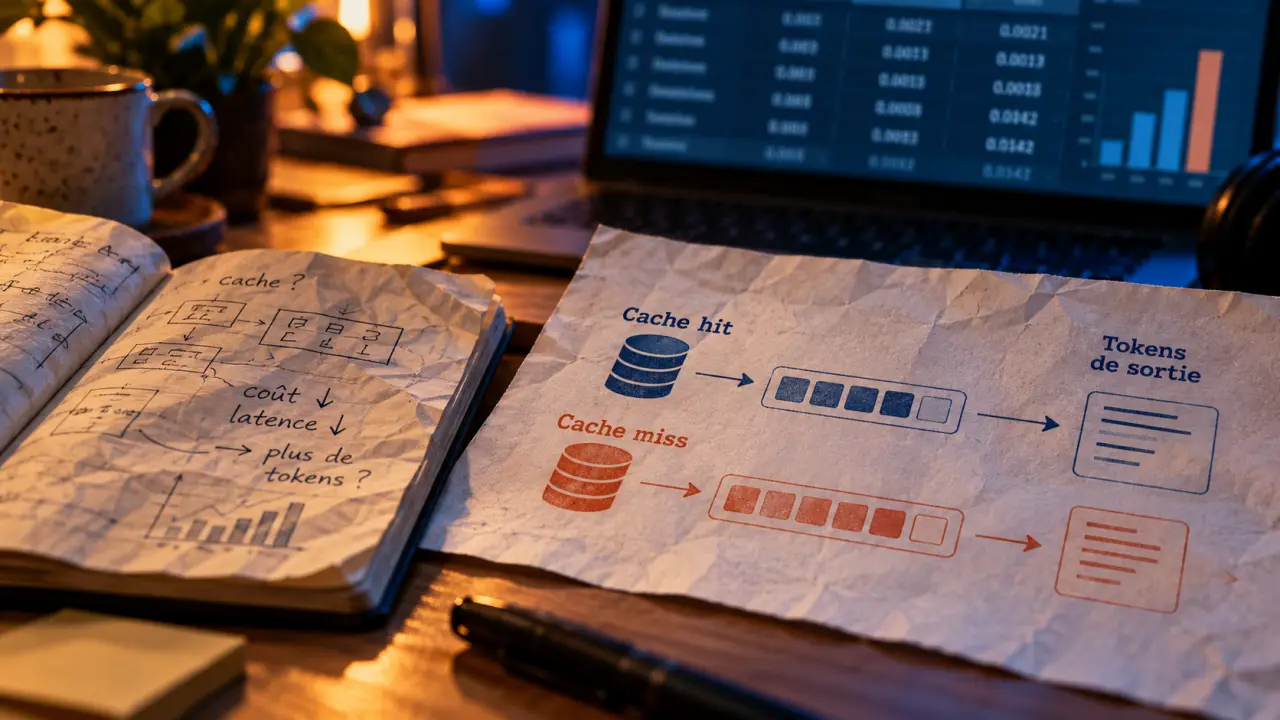
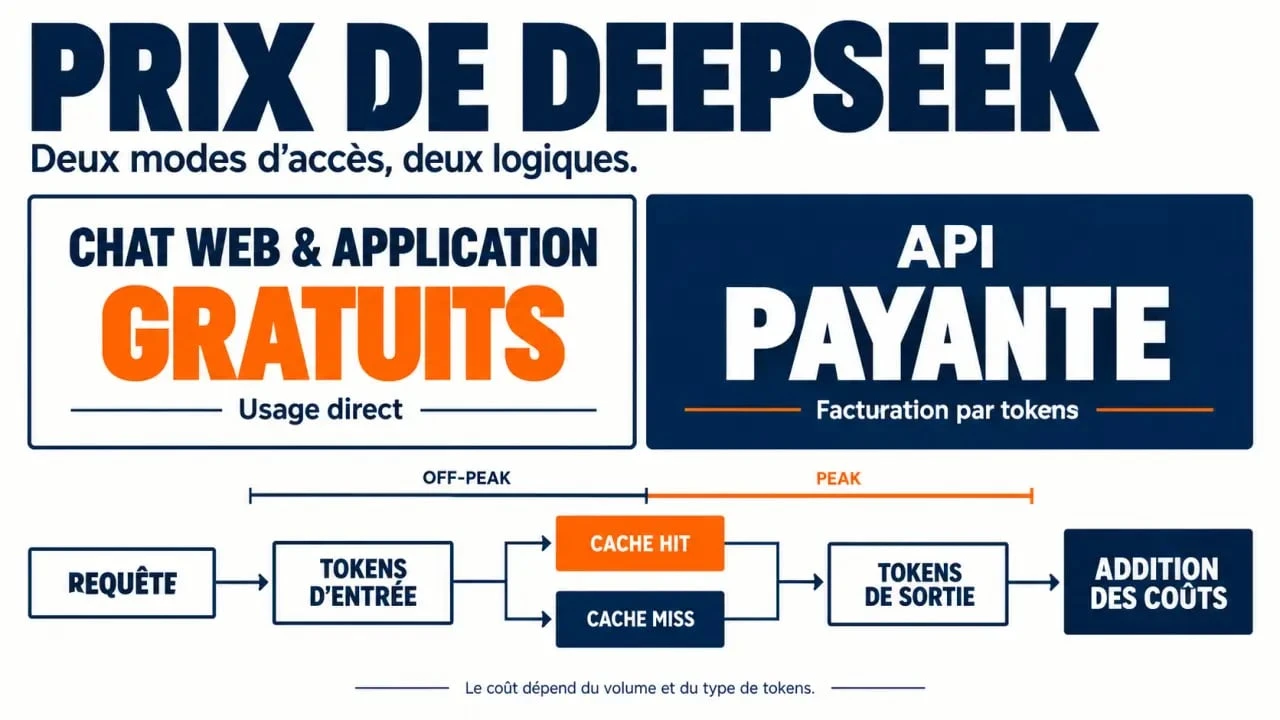
DeepSeek s’utilise gratuitement depuis son interface de chat web ou son application, mais son API est facturée à l’usage. Un échange ponctuel ne génère donc pas le même coût qu’un chatbot intégré, un outil métier ou une automatisation qui envoie des milliers de requêtes. Pour estimer le prix de DeepSeek, il faut regarder le modèle choisi, les tokens envoyés, les tokens générés et la part de contexte réutilisée grâce au cache.
Chat gratuit et API payante : deux accès à ne pas confondre
Le chat DeepSeek est présenté comme gratuit pour les utilisateurs qui échangent directement avec le modèle dans un navigateur ou une application. C’est l’option la plus simple pour rédiger, résumer, traduire, trouver des idées ou tester les capacités de raisonnement, sans intégrer l’IA à un produit.
Calculateur du coût API DeepSeek
Estimez le coût en fonction du modèle, de la période et du volume de tokens utilisés.
Tarifs appliqués
| Composante | Tarif par million |
|---|---|
| Cache hit | $0.007 |
| Cache miss | $0.220 |
| Sortie | $0.660 |
Estimation du coût
Il s’agit d’une estimation fondée sur les tarifs et la période choisis dans l’article. Formule : (tokens cache hit ÷ 1 000 000 × tarif cache hit) + (tokens cache miss ÷ 1 000 000 × tarif cache miss) + (tokens sortie ÷ 1 000 000 × tarif sortie).
L’API DeepSeek répond à une autre logique. Elle permet à un développeur ou à une entreprise d’appeler les modèles depuis un site, un logiciel, un agent IA ou un workflow automatisé. Sa facturation repose sur les tokens consommés, sans prix fixe par requête. Une question courte suivie d’une réponse concise coûte peu. Une analyse de document longue, une conversation avec historique ou une génération de code détaillée coûte davantage.
Cette séparation évite une confusion fréquente : la gratuité du chat ne rend pas gratuite l’utilisation de DeepSeek dans une application. Avant un déploiement, vérifiez aussi les conditions de paiement, les limites de débit, la disponibilité des modèles et la grille tarifaire applicable au moment de l’intégration.
Les prix API DeepSeek par million de tokens
Les tarifs API sont exprimés en dollars par million de tokens. Trois lignes de facturation sont distinguées : les tokens d’entrée servis depuis le cache, les tokens d’entrée absents du cache et les tokens de sortie produits par le modèle. La grille annoncée pour le 16 août 2026 à 16:00 UTC varie selon les périodes off-peak et peak.
| Modèle | Période | Entrée, cache hit, par 1 M de tokens | Entrée, cache miss, par 1 M de tokens | Sortie, par 1 M de tokens |
|---|---|---|---|---|
| DeepSeek Flash | Off-peak | 0,007 $ | 0,22 $ | 0,66 $ |
| DeepSeek Flash | Peak | 0,014 $ | 0,44 $ | 1,32 $ |
| DeepSeek Pro | Off-peak | 0,022 $ | 0,66 $ | 1,98 $ |
| DeepSeek Pro | Peak | 0,044 $ | 1,32 $ | 3,96 $ |
Les créneaux peak indiqués sont 01:00–04:00 et 06:00–10:00 UTC. Les montants appliqués pendant ces périodes correspondent au double des tarifs off-peak. Jusqu’au 16 août 2026 à 15:59 UTC, les tarifs annoncés étaient inférieurs : pour Flash, 0,0028 $ en cache hit, 0,14 $ en cache miss et 0,28 $ en sortie ; pour Pro, 0,003625 $, 0,435 $ et 0,87 $ par million de tokens.
À retenir : un tarif affiché par million de tokens facilite la comparaison entre les modèles, mais il ne correspond pas à une facture minimale. Le coût réel dépend du volume consommé et de la période tarifaire.
Tokens, cache hit et cache miss : ce qui compose réellement la facture
Un token n’est ni exactement un mot ni exactement un caractère
Un token est une unité de texte reconnue par le modèle. Un mot courant peut correspondre à un token, mais un terme technique, une ponctuation, un nombre ou une expression dans une autre langue peut être découpé différemment. Les tokens d’entrée correspondent au prompt, à la consigne, à l’historique de conversation, au document collé ou aux résultats transmis au modèle. Les tokens de sortie correspondent au texte généré par DeepSeek.
Tarifs officiels des modèles et de l’API DeepSeek · Consultez les prix par million de tokens, les modèles disponibles et les informations de facturation de l’API DeepSeek.
La formule de calcul est simple : coût = tokens d’entrée avec cache × tarif cache hit + tokens d’entrée sans cache × tarif cache miss + tokens de sortie × tarif output. Chaque volume doit être divisé par 1 000 000 avant d’être multiplié par le tarif correspondant.
Le cache récompense les préfixes stables
Un cache hit apparaît lorsqu’une partie du contexte d’entrée peut être réutilisée. Un cache miss signifie que le modèle doit traiter ce contenu comme nouveau. Le context caching est particulièrement utile pour les instructions répétées, une base de connaissances identique, un long prompt système ou un assistant qui conserve une structure de réponse stable.
Le coût en production ne dépend pas uniquement du nombre de questions. Un historique ou un document volumineux renvoyé à chaque appel peut augmenter rapidement la consommation. Placez les règles immuables et les documents réutilisés dans un préfixe constant, puis envoyez les variables à la fin. Cette organisation peut améliorer la réutilisation du contexte et rendre les dépenses plus prévisibles, sans garantir un cache hit à chaque requête.
Pour suivre la consommation, les réponses API peuvent notamment faire apparaître prompt_cache_hit_tokens, prompt_cache_miss_tokens et completion_tokens. Ces champs permettent d’observer le comportement réel d’un produit, plutôt que de s’appuyer uniquement sur une estimation théorique.
Calculer un coût DeepSeek par 1 000 tokens ou par requête
Pour convertir un prix par million de tokens en prix par 1 000 tokens, divisez-le par 1 000. En période off-peak, 1 000 tokens de sortie avec Flash reviennent ainsi à 0,00066 $, tandis que 1 000 tokens d’entrée en cache miss coûtent 0,00022 $. Ces montants semblent faibles, mais un service utilisé à grande échelle additionne rapidement les sorties longues et les contextes répétés.
Voici un exemple simple avec DeepSeek Flash en période off-peak. Une requête contient 10 000 tokens d’entrée sans cache et produit 2 000 tokens de sortie :
- entrée : 10 000 / 1 000 000 × 0,22 $ = 0,0022 $ ;
- sortie : 2 000 / 1 000 000 × 0,66 $ = 0,00132 $ ;
- coût total estimé : 0,00352 $.
Si une partie de ces 10 000 tokens est servie par le cache, le coût d’entrée baisse fortement. À l’inverse, demander une explication très détaillée, conserver un historique interminable ou autoriser une sortie trop longue augmente la facture. Fixer une longueur de réponse adaptée, résumer l’historique et mesurer les usages par fonctionnalité sont des moyens simples de maîtriser un budget API.
Flash, Pro ou ChatGPT : choisir selon le travail à accomplir
DeepSeek Flash vise la rapidité et l’économie. Il convient aux réponses de support client, aux extractions simples, aux classements, aux reformulations, à la génération de brouillons et aux automatisations à fort volume. DeepSeek Pro est plus adapté lorsqu’un niveau de raisonnement supérieur, une analyse structurée ou des tâches de code complexes justifient un coût plus élevé.
Le choix ne se résume pas au prix par million de tokens. Un modèle moins cher qui demande plusieurs relances, produit une réponse insuffisante ou nécessite de nombreuses corrections peut coûter davantage au final qu’un modèle plus performant utilisé une seule fois. Pour un test sérieux, comparez le taux de réussite, le temps de traitement, la longueur moyenne des sorties et le coût par tâche finalisée.
Face à ChatGPT et aux modèles d’OpenAI, DeepSeek est souvent positionné comme une option économique pour l’API. Les tarifs comparatifs cités de 0,55 $ en entrée et 2,19 $ en sortie par million de tokens restent nettement inférieurs à ceux mentionnés pour OpenAI o1, soit 15 $ en entrée et 60 $ en sortie. Cette comparaison ne vaut toutefois que pour des modèles, des capacités et des conditions d’utilisation comparables. La qualité attendue, la compatibilité technique, la fiabilité et les exigences de confidentialité comptent aussi dans le choix.
Établir un budget API sans mauvaise surprise
Avant de choisir DeepSeek pour un projet, définissez un scénario mesurable : nombre de requêtes mensuelles, taille moyenne des prompts, longueur cible des réponses, volume de contexte réutilisable et besoin réel de raisonnement. Testez ensuite Flash et Pro sur un échantillon représentatif, plutôt que sur trois questions trop simples.
- Commencez par le chat gratuit pour qualifier les cas d’usage.
- Mesurez les tokens réels via l’API sur un jeu de requêtes proche de la production.
- Repérez les longs préfixes qui peuvent être stabilisés pour favoriser le cache.
- Fixez un plafond de sortie et un budget mensuel par fonctionnalité.
- Vérifiez la grille officielle avant toute mise en production, car les modèles, les créneaux et les tarifs peuvent évoluer.
Le meilleur prix DeepSeek n’est donc pas automatiquement celui du modèle le moins cher. C’est celui qui fournit une réponse exploitable, avec un volume de tokens maîtrisé et un niveau de performance cohérent avec l’usage.
Partager cet article
Articles qui pourraient vous intéresser :
 CashMaster Ultimate face au tableur : un logiciel de trésorerie solide, pas une suite complète
 Gratuit ou payant : quel logiciel de montage vidéo choisir selon votre usage ?
 Intelligence artificielle 3D : générer, réparer et exporter sans livrer un maillage inutilisable
 Génération d’images avec DeepSeek : Janus Pro et l’optimisation par le texte