DeepSeek-V2 vs GPT-4 Turbo et Claude 3 Opus : la puissance MoE sans la facture
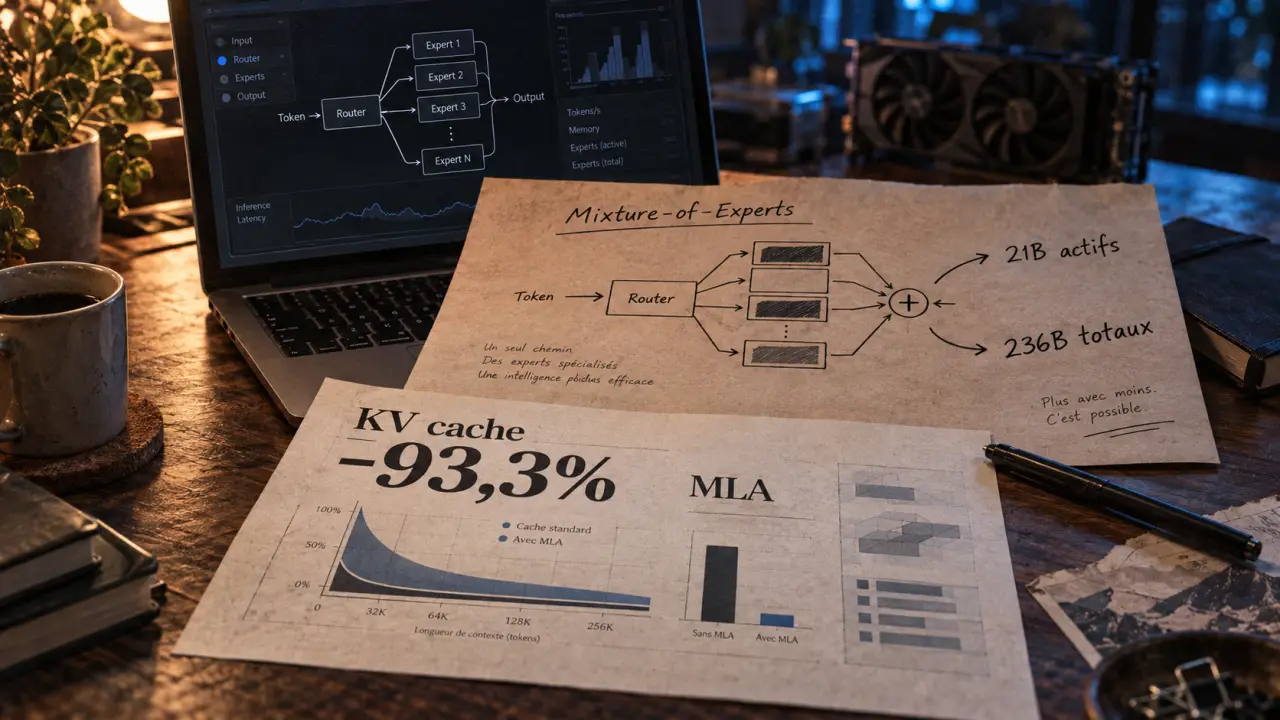
DeepSeek-V2 est un modèle de langage open source construit sur une architecture Mixture-of-Experts : 236 milliards de paramètres au total, mais seulement 21 milliards activés à chaque token traité. Ce choix technique change concrètement la donne pour qui veut déployer une IA générative puissante sans les coûts d’infrastructure d’un modèle dense classique. Voici ce qu’il faut comprendre avant de l’adopter, de le comparer à la concurrence ou de l’installer. Avant une mise en production, il faut toutefois évaluer les limites de censure susceptibles d’influencer certaines réponses du modèle.
Qu’est-ce que DeepSeek-V2 exactement ?
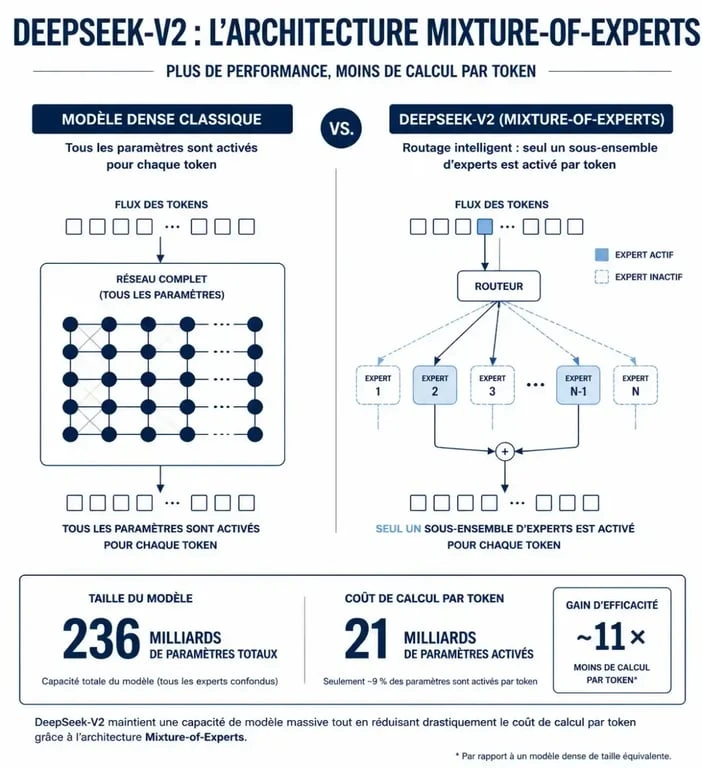
DeepSeek-V2 est un modèle de langage généraliste publié par DeepSeek AI, pensé pour rivaliser avec les grands modèles propriétaires tout en restant accessible sous licence ouverte. Sa particularité tient à son architecture Mixture-of-Experts (MoE) : plutôt que d’activer l’intégralité de son réseau de neurones à chaque requête, le modèle ne mobilise qu’un sous-ensemble de ses « experts » internes. Résultat, sur 236 milliards de paramètres totaux, seuls 21 milliards sont réellement actifs par token généré. Le modèle a été entraîné sur 8,1 trillions de tokens, un volume qui lui permet de couvrir un spectre large de connaissances générales, de raisonnement et de compréhension multilingue, notamment en chinois et en anglais.
Sur le plan de la licence, DeepSeek-V2 est distribué sous licence MIT pour le code, complétée par une Model License qui autorise explicitement l’usage commercial. Concrètement, une entreprise peut intégrer le modèle dans un produit payant sans négociation contractuelle préalable, ce qui le distingue nettement des modèles fermés comme GPT-4 Turbo ou Claude 3 Opus, dont l’accès passe uniquement par une API payante et des conditions d’utilisation propriétaires.
Pourquoi l’architecture MoE change la donne
Un modèle dense classique doit activer tous ses paramètres pour chaque token, ce qui fait grimper linéairement le coût de calcul avec la taille du modèle. L’architecture MoE de DeepSeek-V2, appelée DeepSeekMoE pour sa partie réseaux Feed-Forward, route chaque token vers un nombre restreint d’experts spécialisés parmi l’ensemble disponible. Le modèle garde ainsi une capacité de connaissance équivalente à un modèle dense bien plus gros, tout en gardant un coût d’inférence proche de celui d’un modèle beaucoup plus petit. C’est ce compromis qui explique pourquoi DeepSeek-V2 peut afficher des performances comparables à des modèles fermés tout en coûtant significativement moins cher à faire tourner.
L’innovation technique derrière les chiffres : MLA et réduction du KV cache
Au-delà du MoE, DeepSeek-V2 introduit une deuxième innovation clé : le Multi-head Latent Attention (MLA). Dans les modèles transformers classiques, chaque token génère un cache clé-valeur (KV cache) qui grossit avec la longueur du contexte et pèse lourd sur la mémoire GPU disponible, en particulier pour les longues conversations ou les gros documents. MLA compresse ces représentations dans un espace latent de dimension réduite avant de les stocker, ce qui permet de réduire le KV cache de 93,3 % par rapport à une attention classique.
Cette compression n’est pas qu’un détail d’ingénierie : elle se traduit directement par un débit de génération multiplié par 5,76 par rapport à DeepSeek 67B, le modèle dense qui précédait V2 chez le même éditeur. Sur le plan de l’entraînement, DeepSeek annonce une économie de 42,5 % des coûts de calcul comparé à ce même modèle 67B, pour une capacité globale supérieure. C’est cette combinaison (plus de paramètres totaux, moins de calcul actif, moins de mémoire consommée) qui permet à DeepSeek-V2 de tenir tête à des modèles bien plus coûteux à opérer.
Ce que cela change concrètement pour l’inférence
Pour un développeur qui déploie le modèle localement, la réduction du KV cache signifie qu’on peut traiter des contextes plus longs ou plus de requêtes simultanées avec la même quantité de VRAM. Pour l’inférence en BF16 du modèle complet à 236 milliards de paramètres, 8 GPU de 80 Go sont recommandés, une configuration qui reste hors de portée d’un poste de développeur individuel, mais qui est nettement plus légère que ce qu’exigerait un modèle dense de taille équivalente sans les optimisations MLA et MoE.
DeepSeek-V2 vs DeepSeek Coder V2 : ne pas confondre les deux modèles
C’est la confusion la plus fréquente autour de ce nom : DeepSeek-V2 et DeepSeek Coder V2 ne sont pas le même modèle, même s’ils partagent la même architecture de base. DeepSeek-V2 est un modèle généraliste, conçu pour la conversation, le raisonnement, la rédaction et les tâches de connaissances générales. DeepSeek Coder V2 est une déclinaison spécialisée, entraînée avec 6 trillions de tokens supplémentaires ciblant spécifiquement le code, et disponible dans des variantes plus légères (16B de paramètres totaux, 2,4B actifs) en plus de la version complète (236B / 21B actifs, la même taille que V2).
La différence la plus marquante concerne la fenêtre de contexte et la couverture linguistique en programmation. DeepSeek Coder V2 étend le contexte à 128 000 tokens, contre 16 000 pour la première génération, ce qui permet d’analyser des bases de code entières plutôt que des fragments isolés. Côté langages, sa couverture passe de 86 à 338 langages de programmation supportés. Sur le papier, cette version aurait été la première publication open source à dépasser GPT-4 Turbo sur certains benchmarks de code.
Comment DeepSeek-V2 se positionne face à GPT-4 Turbo, Claude 3 Opus, LLaMA 3 70B et Mixtral
Sur les benchmarks de connaissances générales, DeepSeek-V2 obtient un score de 78,5 % , un niveau qui le place dans la même tranche que les meilleurs modèles fermés disponibles à l’époque de sa sortie. Sur les tâches de résolution de problèmes de programmation, le score de base atteint 48,8 %, avec une nette progression après fine-tuning : 81,1 % en codage et 92,2 % en mathématiques pour les versions ajustées. En comparaison, le score brut en mathématiques avant fine-tuning s’établit à 79,2 %.
Pour la génération en chinois, DeepSeek-V2 affiche un score AlignBench comparable à celui de GPT-4, ce qui en fait l’un des rares modèles à rivaliser frontalement sur ce terrain linguistique spécifique, un axe sur lequel Claude 3 Opus et LLaMA 3 70B sont historiquement moins optimisés. Face à Mixtral, autre modèle MoE open source, DeepSeek-V2 se distingue par un ratio paramètres actifs/capacité totale plus favorable, ce qui se traduit par un débit d’inférence supérieur à contexte équivalent.
Comment lire ces chiffres sans se faire biaiser
Un score de benchmark isolé ne dit jamais tout : deux modèles peuvent afficher un pass@1 identique sur HumanEval et se comporter très différemment sur une tâche de refactoring réel, là où le contexte, la cohérence multi-fichiers et la gestion des dépendances comptent davantage que la génération d’une fonction isolée. Mieux vaut donc lister ses propres contraintes (budget GPU, langage de programmation dominant dans l’équipe, besoin ou non d’un contexte de 128K tokens, tolérance à l’hébergement de données hors Union européenne) avant de regarder les benchmarks, plutôt que de courir après le score le plus haut. Un modèle légèrement moins performant sur le papier, mais bien calibré sur ces critères concrets, rendra souvent un meilleur service qu’un champion de leaderboard mal adapté au terrain.
Comment installer et utiliser DeepSeek-V2
Plusieurs voies d’accès existent selon le niveau de contrôle recherché. Pour un usage sans infrastructure, l’API DeepSeek est compatible avec le format OpenAI, ce qui permet de la brancher sur des outils déjà configurés pour GPT-4 en changeant simplement l’URL de base et la clé d’API. C’est l’option la plus rapide pour tester le modèle dans un IDE ou un pipeline existant.
Pour un déploiement local, les poids du modèle sont disponibles sur Hugging Face, répartis en collections Base, Instruct et Lite. Le serveur d’inférence vLLM propose une image Docker prête à l’emploi (vllm/vllm-openai) qui expose une API compatible OpenAI directement depuis le modèle téléchargé. SGLang constitue une alternative, particulièrement adaptée aux charges de production avec beaucoup de requêtes concurrentes. Pour un usage plus léger, individuel ou exploratoire, Ollama permet de lancer une version quantifiée du modèle sur une seule machine, à condition d’accepter une perte de précision liée à la quantisation 4-bit ou 8-bit.
Choisir sa variante selon les ressources disponibles
Le choix entre Base, Instruct et Lite dépend directement du cas d’usage et du matériel disponible. La version Base convient à qui veut fine-tuner le modèle sur ses propres données ou construire une application sur mesure au-dessus du modèle brut. La version Instruct est pré-entraînée pour suivre des instructions et répondre directement en mode conversationnel, adaptée à un usage direct sans étape d’ajustement supplémentaire. La version Lite, avec son nombre de paramètres actifs réduit, cible les configurations GPU plus modestes ou les besoins de latence très basse, au prix d’une capacité de raisonnement légèrement inférieure à la version complète.
Cas d’usage concrets et points de vigilance
Pour une équipe de développement, DeepSeek-V2 et sa déclinaison Coder V2 trouvent leur intérêt sur plusieurs fronts : complétion de code contextuelle sur de gros dépôts grâce à la fenêtre étendue à 128K tokens , refactoring assisté qui s’appuie sur la compréhension de fichiers multiples plutôt que d’un extrait isolé, génération de documentation technique, et traduction ou adaptation de contenus multilingues. La licence commerciale ouverte simplifie aussi l’intégration dans un produit revendu, sans les clauses restrictives qui accompagnent certains modèles fermés.
Ce déploiement mérite néanmoins deux réserves pratiques. D’abord, la qualité des réponses reste dépendante de la précision des instructions fournies : un prompt vague produit des résultats plus inégaux qu’avec un modèle davantage rodé au suivi d’instructions ambiguës. Ensuite, si l’usage passe par l’API DeepSeek plutôt que par un déploiement local, les données transitent par des serveurs situés hors Union européenne, un point à examiner attentivement avant tout traitement de données sensibles ou soumises au RGPD . Pour ces cas, l’auto-hébergement via vLLM ou SGLang reste la solution la plus sûre, au prix d’un investissement GPU plus conséquent.

- Pince robotique : vérifiez ces 4 compatibilités avant le montage - 19 octobre 2026
- Kit robotique Arduino : le mauvais choix peut laisser le robot immobile - 18 octobre 2026
- Android 16 sécurise vos données, à condition d’activer ces réglages - 1 octobre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Courrier et intelligence artificielle : rédiger, réécrire et adapter vos écrits en quelques secondes
 DeepSeek V4-Pro ou V4-Flash : le bon choix pour le code, les agents et le long contexte ?
 Pax Historia DeepSeek not working : modèle indisponible, rate limit ou fournisseur ?
 Janus-Pro de DeepSeek : un score supérieur à DALL-E 3, mais des limites concrètes