DeepSeek jailbreak : 58 % d’échecs aux tests, quelles défenses prioriser ?
Un jailbreak DeepSeek désigne une tentative de contournement des règles de sécurité d’un modèle pour obtenir une réponse qu’il devrait refuser. Le sujet dépasse les « prompts secrets » : il concerne la robustesse de DeepSeek-R1 et DeepSeek-Chat, la sécurité des applications qui les intègrent et la protection des données traitées par l’IA.
Jailbreak, prompt injection et obfuscation : trois risques à ne pas confondre
Un jailbreak cherche à modifier le comportement global du modèle. L’attaquant tente de neutraliser ou de contourner ses garde-fous pour provoquer une sortie dangereuse, illégale, discriminatoire, violente, médicalement erronée ou susceptible de faciliter l’exploitation d’une vulnérabilité. Le but est de faire abandonner au LLM ses règles de refus et ses limites d’utilisation.
La prompt injection est plus ciblée. Elle consiste à introduire des instructions concurrentes dans une conversation, un document, une page web ou une base de connaissances consultée par le modèle. Dans une application connectée à des outils, elle peut détourner l’agent de sa tâche, lui faire révéler des informations ou influencer ses actions. Cette famille d’attaque correspond notamment au risque OWASP LLM01.
L’obfuscation, enfin, masque l’intention réelle d’une requête au moyen d’une formulation indirecte, d’un texte fragmenté, d’un encodage ou de substitutions typographiques. Elle ne constitue pas nécessairement une attaque autonome, mais peut aider à franchir un filtre d’entrée trop littéral. Les défenses doivent donc analyser le sens, le contexte conversationnel et l’intention probable, plutôt qu’une simple liste de mots interdits.
| Technique | Cible principale | Risque opérationnel | Réponse défensive |
|---|---|---|---|
| Jailbreak | Règles de sûreté du modèle | Sortie non conforme ou dangereuse | Guardrails, filtrage de sortie, red teaming |
| Prompt injection | Instructions, contexte et outils | Exfiltration ou action non autorisée | Séparation des privilèges et validation des actions |
| Obfuscation | Détecteurs superficiels | Contournement des contrôles d’entrée | Analyse sémantique et normalisation du texte |
Pourquoi DeepSeek-R1 et DeepSeek-Chat doivent être évalués séparément
DeepSeek regroupe plusieurs modèles et modes de déploiement : variantes locales, modèles distillés, API hébergées et offres orientées vers le raisonnement. Les résultats observés sur l’un ne se transposent pas automatiquement à l’autre. La taille du modèle, sa version, le message système, les paramètres d’inférence, le contexte fourni et les filtres ajoutés par l’intégrateur modifient la surface d’attaque.
Comprendre et prévenir les attaques par prompt injection · La ressource officielle de l’OWASP explique les vulnérabilités de prompt injection et les moyens de sécuriser les applications d’IA générative.
Le raisonnement étendu ouvre une surface d’interaction supplémentaire
Les modèles de raisonnement comme DeepSeek-R1 sont étudiés parce qu’ils acceptent des instructions longues, contradictoires ou structurées comme une résolution de problème. Une attaque peut chercher à créer des objectifs concurrents, à manipuler les étapes intermédiaires ou à utiliser un persona fictif. Le raisonnement ne rend pas un modèle intrinsèquement dangereux. Il impose toutefois de tester les chemins par lesquels une consigne apparemment anodine peut déplacer progressivement la réponse hors du cadre prévu.
Dans une architecture agentique, le message système sert d’ancre : il fixe le rôle du modèle, ses autorisations et ses interdits. Si cette ancre est noyée dans des documents non fiables, ou si l’agent peut appeler des outils avec des droits trop larges, le problème dépasse la qualité du refus. Une réponse persuasive peut alors déclencher une action. Il faut traiter tout contenu externe comme non fiable et demander une validation explicite avant tout accès sensible, export de données ou opération irréversible.
Les comparaisons ne valent que pour un protocole identique
Le projet GitHub JailBreak-DeepSeek évalue cinq modèles DeepSeek : R1 1.5B, R1 7B, R1 8B, Reasoner et Chat. Il les compare à GPT-4 et Claude 1.3 à partir d’un dataset de 32 prompts adversariaux. Cette approche permet de visualiser les écarts entre modèles, notamment avec des heatmaps, mais elle ne permet pas d’affirmer qu’un fournisseur est durablement plus sûr qu’un autre. Les versions, les politiques et les protections évoluent.
Ce que révèlent les tests : les attaques combinées évaluent mieux la robustesse
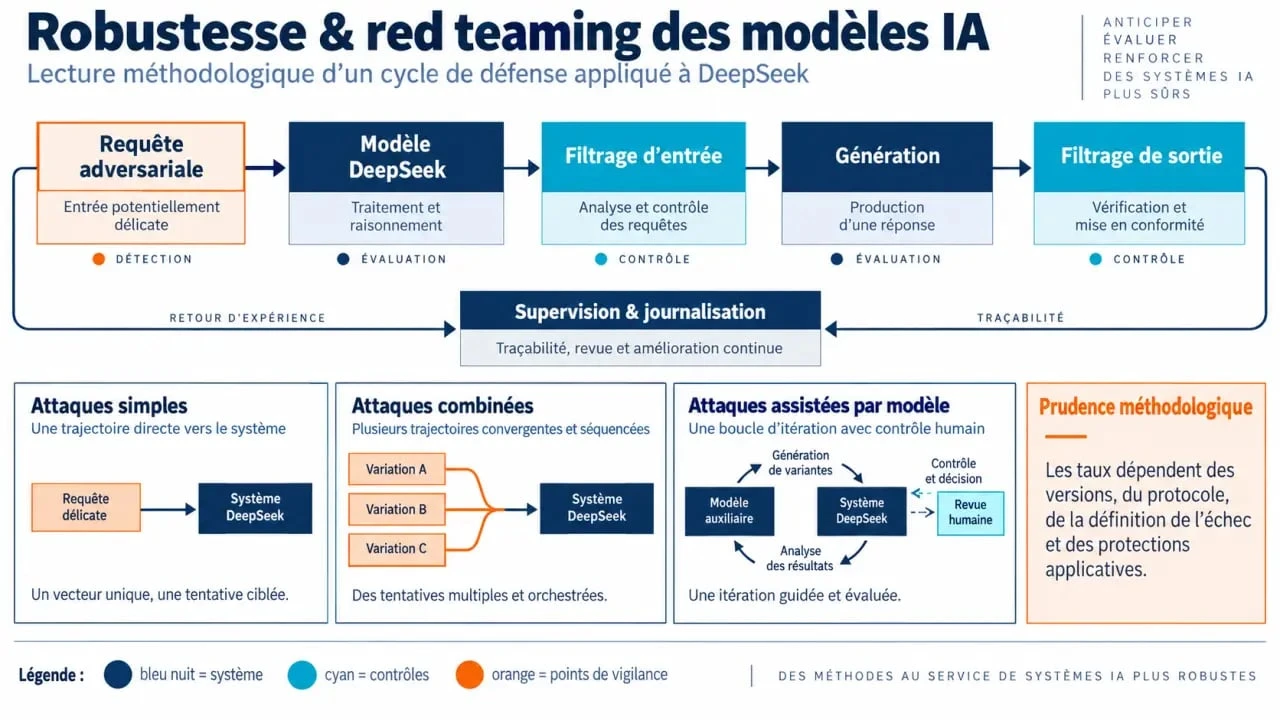
Les campagnes de red teaming distinguent généralement les attaques simples, les attaques combinées et les attaques assistées par modèle. Les premières isolent un mécanisme. Les deuxièmes associent plusieurs manipulations. Les dernières utilisent un autre LLM pour transformer ou varier automatiquement les requêtes. Cette progression évite de surestimer une défense qui résiste à un seul contournement, mais échoue lorsque plusieurs stratégies sont associées.
- Attaques simples : injection de préfixe, tentative de suppression d’un refus, changement de style, persona non restreint ou instruction distractrice.
- Attaques combinées : association d’obfuscation, de découpage du payload et de reconstruction progressive du contenu.
- Attaques assistées par modèle : génération de variantes adversariales et adaptation aux réponses précédentes, sans publier de consignes directement réutilisables.
Le projet cité recense 7 stratégies simples, 3 stratégies combinées et 2 stratégies assistées par modèle. Son intérêt tient moins à la reproduction mécanique des tests qu’à la méthode : comparer les taux de refus, classer les résultats et examiner les écarts entre les familles d’attaque.
Les évaluations de Qualys TotalAI apportent un repère complémentaire. Sur 891 évaluations couvrant 16 catégories de knowledge base, Qualys a relevé 61 % d’échecs. Sur 885 attaques de jailbreak réparties entre 18 types, le taux d’échec atteint 58 %. Ces chiffres indiquent une exposition importante dans le périmètre mesuré. Ils ne décrivent pas tous les déploiements DeepSeek. La définition d’un « échec », le modèle évalué, la version ciblée et les règles applicatives doivent être documentés.
Mettre en place un red teaming DeepSeek sans diffuser de contenu dangereux
Un test responsable commence par un périmètre clair : modèles concernés, interfaces exposées, données autorisées, catégories de risque et critères de réussite. Il se déroule dans un environnement isolé, avec des données fictives ou anonymisées, sans accès aux systèmes de production et sans publication de payloads exploitables. Les tests peuvent être menés localement avec Ollama ou via une API, à condition de respecter les règles d’usage et de maîtriser les journaux produits.
- Définir les scénarios métiers : assistant client, recherche documentaire, génération de code ou agent connecté à des outils.
- Préparer des cas adversariaux neutralisés couvrant les instructions contradictoires, l’obfuscation, la fuite de contexte et les sorties sensibles.
- Consigner chaque réponse, le contexte, la version du modèle, les réglages et la décision d’évaluation.
- Faire examiner les résultats par un modèle juge, puis par une revue humaine pour les cas ambigus.
- Corriger les faiblesses, rejouer les mêmes tests et suivre l’évolution avec une matrice ou une heatmap.
Les preuves doivent rester minimales et protégées. Conserver intégralement les traces de raisonnement ou les conversations peut créer un nouveau risque de confidentialité. Il est préférable de journaliser les identifiants de test, les catégories, les verdicts, les extraits strictement nécessaires et les actions de remédiation.
Défendre une application DeepSeek : filtres, moindre privilège et gouvernance
Aucun guardrail natif ne suffit seul. Une défense en profondeur combine le filtrage des entrées, les règles de sortie, la gestion rigoureuse des outils, la supervision et des tests récurrents. Des solutions spécialisées, comme Wardstone Guard ou une API de sécurité LLM, peuvent compléter ce dispositif. Elles doivent elles aussi être évaluées selon leurs faux positifs et leurs faux négatifs.
- Avant la génération : normaliser les entrées, détecter les consignes contradictoires et isoler les données ou documents non fiables.
- Pendant l’exécution : appliquer le principe de moindre privilège aux connecteurs, aux clés API et aux actions accessibles à l’agent.
- Après la génération : filtrer les sorties, bloquer les contenus à risque et orienter les cas douteux vers une validation humaine.
- En continu : surveiller les tentatives répétées, analyser les tendances et rejouer les campagnes après chaque évolution du modèle ou de l’application.
Pour une entreprise, la sécurité du modèle doit s’accompagner d’une gouvernance des données : localisation de l’hébergement, nature des informations transmises, durée de conservation des logs, droits d’accès et exigences réglementaires sectorielles. Le bon indicateur n’est donc pas seulement le taux de refus d’un modèle. Il mesure aussi sa capacité à rester contrôlable dans l’application réelle, avec ses utilisateurs, ses documents et ses connexions métiers.

- Android 16 sécurise vos données, à condition d’activer ces réglages - 1 octobre 2026
- DeepSeek en français : 4 repères pour obtenir des réponses précises - 27 septembre 2026
- L’intelligence artificielle responsable : un cadre concret pour garder la maîtrise des décisions - 25 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 3 copies, cloud et disque externe : la méthode simple pour faire une sauvegarde de son PC
 11,7 millions de comptes ANTS concernés, biométrie et pièces jointes hors de l’incident
 Sécurité du cloud : responsabilité partagée, IAM et erreurs de configuration à éviter
 Gouvernance des données vs sécurité des données : le cadre qui décide, les contrôles qui protègent