L’intelligence artificielle responsable : un cadre concret pour garder la maîtrise des décisions
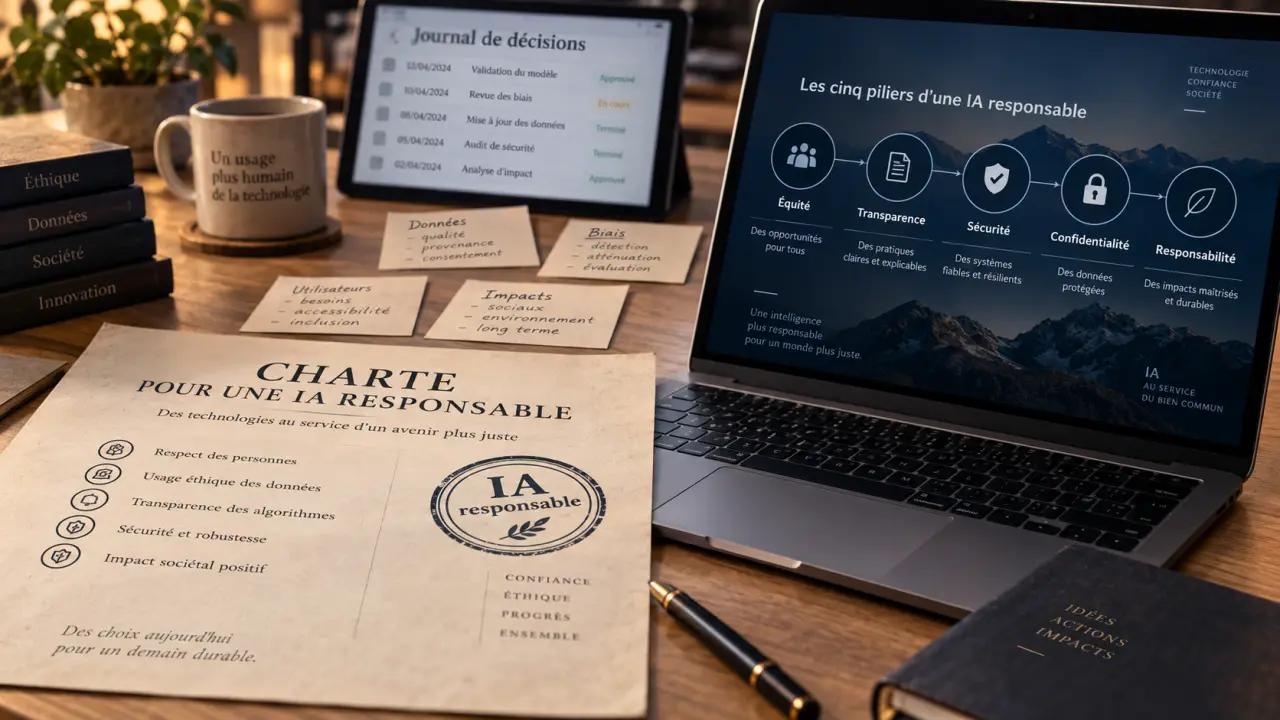
Une intelligence artificielle responsable ne se résume pas à ajouter une charte éthique après le déploiement d’un outil. Elle guide la conception, l’achat, l’utilisation et la surveillance des systèmes d’IA pour qu’ils restent utiles, compréhensibles et maîtrisables. Pour une entreprise, l’enjeu est concret : profiter de l’automatisation et de l’aide à la décision sans exposer ses clients, ses équipes ou sa réputation à des erreurs évitables.
Ce que recouvre réellement l’intelligence artificielle responsable
L’intelligence artificielle responsable désigne un ensemble de pratiques visant à rendre les systèmes d’IA fiables, équitables, transparents, sécurisés et gouvernables. Cette approche couvre tout le cycle de vie : définition du besoin métier, collecte des données, entraînement du modèle, tests, mise en production, suivi des usages et retrait éventuel du système.
Testez vos connaissances sur l’intelligence artificielle responsable
Répondez aux six questions, puis validez pour découvrir votre score et les explications.
Une seule réponse est correcte par question.
Le sujet dépasse donc la performance technique. Un modèle peut produire des prédictions précises en moyenne tout en désavantageant un groupe de personnes, en utilisant des données trop sensibles ou en restant impossible à contester. Une démarche d’IA responsable cherche à repérer ces situations avant qu’elles ne deviennent des incidents métier, juridiques ou humains.
Éthique, gouvernance et IA responsable : des notions complémentaires
L’éthique de l’IA pose les grandes questions : quel usage est acceptable, quels dommages faut-il prévenir et quelles valeurs l’organisation souhaite-t-elle défendre ? La gouvernance de l’IA traduit ces intentions en rôles, contrôles, processus de validation et mécanismes d’alerte. L’IA responsable applique ensuite cet ensemble aux produits et aux décisions quotidiennes.
L’éthique fixe la direction, la gouvernance organise la responsabilité et l’IA responsable vérifie que le système suit effectivement cette trajectoire. Cette distinction évite de réduire le sujet à une déclaration de principes sans effet sur les pratiques.
Les exigences à examiner avant de faire confiance à un modèle
Les piliers de la confiance se renforcent mutuellement. Une organisation ne doit pas choisir entre confidentialité et explicabilité, par exemple. Elle doit définir le niveau de contrôle adapté à chaque cas d’usage, surtout lorsqu’une IA intervient dans une prise de décision à fort enjeu.
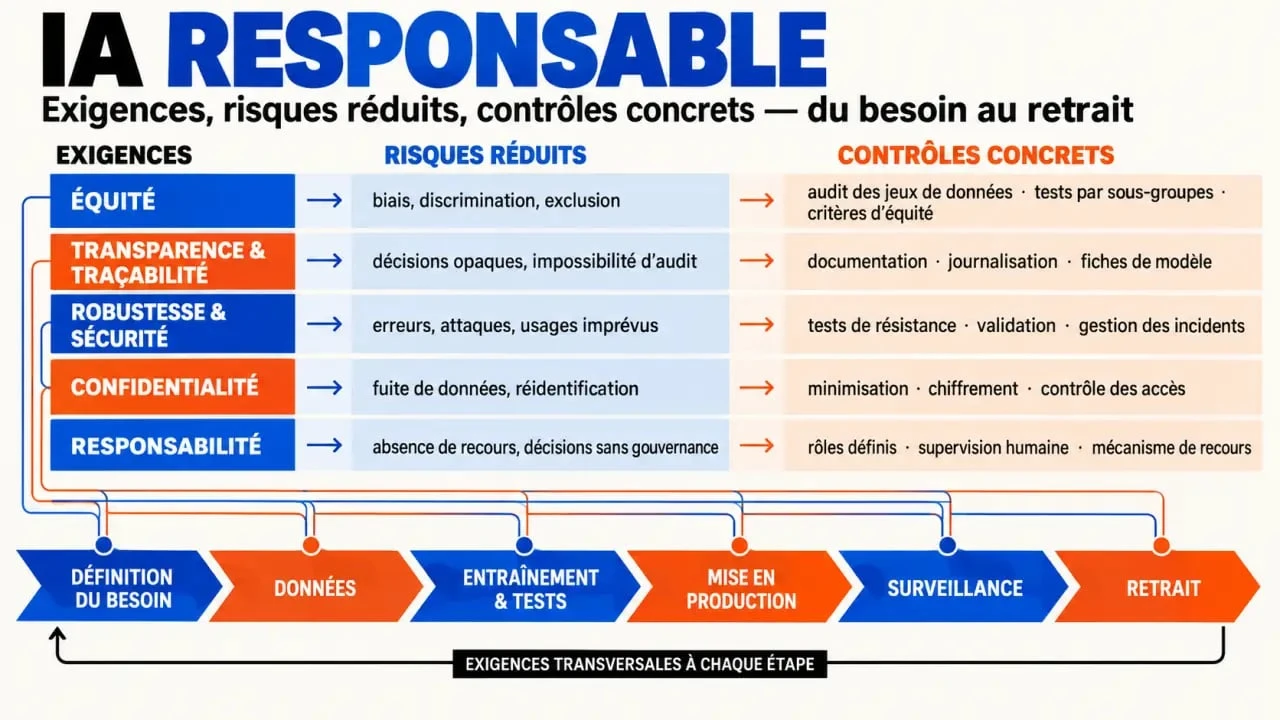
| Exigence | Risque réduit | Contrôle utile |
|---|---|---|
| Équité | Discrimination statistique indésirable | Comparer les résultats entre groupes pertinents |
| Transparence et traçabilité | Décisions impossibles à comprendre ou à auditer | Documenter les données, la version du modèle et sa finalité |
| Robustesse et sécurité | Erreurs, instabilité et attaques malveillantes | Tester les cas limites et surveiller les performances |
| Confidentialité | Fuite ou usage abusif de données personnelles | Limiter les accès et appliquer le privacy by design |
| Responsabilité | Absence de décisionnaire en cas d’incident | Désigner un propriétaire métier et un responsable du contrôle |
Explicabilité : pouvoir justifier une décision
L’explicabilité répond à une question simple : pourquoi le modèle a-t-il recommandé cette action ou produit cette réponse ? Elle ne signifie pas forcément que chaque ligne de code est lisible. Elle suppose plutôt que les personnes concernées peuvent comprendre les facteurs déterminants, les limites connues et la marche à suivre pour demander une révision humaine.
Cette exigence devient essentielle pour le recrutement, l’assurance, le crédit, la santé ou la détection de fraude. Une interface claire, des journaux de décision et une documentation accessible sont souvent plus utiles qu’une explication mathématique réservée aux data scientists.
Les biais ne viennent pas seulement de l’algorithme
Les biais peuvent se trouver dans les données d’entraînement, la définition de la cible à prédire, les variables retenues ou la manière dont les résultats sont interprétés. Une donnée historique peut refléter des pratiques inéquitables passées. La reprendre sans recul risque alors d’automatiser une discrimination déjà existante.
Les méthodes d’atténuation comprennent le rééchantillonnage, la repondération, l’amélioration de la représentativité des jeux de données et l’évaluation par sous-groupes. Aucun correctif technique ne remplace toutefois une question préalable : la décision doit-elle vraiment être automatisée, et quel recours est offert à la personne affectée ?
Les risques changent selon le type d’IA utilisé
Les modèles de machine learning traditionnels et l’IA générative partagent plusieurs risques : données biaisées, perte de confidentialité, dérive des performances et opacité. Leurs modes de défaillance diffèrent toutefois. Les contrôles doivent donc être adaptés au système et à son usage, plutôt que définis par une politique uniforme.
Le cadre officiel du NIST pour maîtriser les risques liés à l’IA · Une référence volontaire pour intégrer la fiabilité, la sécurité et la responsabilité dans la conception et la gestion des systèmes d’IA.
IA prédictive : attention à la dérive silencieuse
Un modèle de scoring, de prévision ou de détection apprend à partir d’une situation donnée. Lorsque les comportements, les marchés ou les données changent, ses résultats peuvent se dégrader : c’est le data drift. Un monitoring continu doit suivre la précision, la stabilité des variables et les écarts éventuels entre populations. La cross-validation aide à évaluer le modèle avant sa mise en production, mais elle ne remplace pas le suivi en conditions réelles.
Un modèle n’est pas un objet figé. Ses paramètres reposent sur des hypothèses qui peuvent devenir moins pertinentes lorsque le contexte change. Des seuils d’alerte, des revues périodiques et la possibilité de revenir à un processus manuel évitent que cette dégradation progressive ne conduise à une décision automatisée injustifiée.
IA générative : vérifier avant de diffuser
Les modèles génératifs peuvent produire du texte, du code, des images ou des synthèses convaincantes, mais inexactes. Les hallucinations, la toxicité, la désinformation, la divulgation d’informations confidentielles et les questions de propriété intellectuelle doivent être prises en compte dès la conception du cas d’usage.
Dans un assistant destiné aux collaborateurs, il est prudent de limiter les données transmises au modèle, d’encadrer les sources autorisées, d’afficher les incertitudes et de réserver une validation humaine aux contenus externes, sensibles ou engageants. Une réponse fluide ne prouve pas sa fiabilité.
Mettre en place une démarche utile, de l’idée au suivi
La bonne approche consiste à proportionner les contrôles au niveau de risque. Un outil qui reformule des notes internes n’appelle pas le même dispositif qu’un système qui priorise des candidatures ou influence l’accès à un service. L’objectif est de rendre les décisions d’adoption documentées et défendables, sans bloquer les usages pertinents.
Créer un parcours de validation simple et traçable
- Qualifier le cas d’usage : préciser la finalité, les utilisateurs, les personnes affectées, l’impact potentiel et le niveau d’automatisation.
- Cartographier les données : vérifier leur origine, leur qualité, les droits d’usage, la présence de données personnelles, la durée de conservation et les accès.
- Tester avant le déploiement : évaluer la performance, les biais, la robustesse, la sécurité et les scénarios de mauvaise utilisation.
- Documenter les choix : consigner les limites, les indicateurs, la version du modèle, les procédures d’escalade et le décisionnaire désigné.
- Surveiller après la mise en service : suivre les incidents, les retours utilisateurs, la dérive, les changements de données et la nécessité d’une nouvelle évaluation.
Faire de la responsabilité une compétence collective
La gouvernance de l’IA ne relève pas uniquement de l’équipe technique. Les métiers définissent le besoin et les seuils d’acceptabilité. Les spécialistes des données évaluent les modèles. Les équipes de sécurité et de protection des données contrôlent les accès. Les juristes et les responsables conformité éclairent les obligations. Un comité d’examen éthique peut arbitrer les cas sensibles, à condition d’avoir un mandat clair et la capacité réelle de demander des corrections.
Enfin, l’achat d’une solution externe ne transfère pas toute la responsabilité au fournisseur. Avant de choisir un outil, il faut demander quelles données il traite, comment les modèles sont évalués, quelles garanties de sécurité sont prévues, quelles traces sont disponibles et comment un incident est géré. Une intelligence artificielle responsable se juge autant à la qualité de ces réponses qu’à celle d’une démonstration.

- Android 16 sécurise vos données, à condition d’activer ces réglages - 1 octobre 2026
- DeepSeek en français : 4 repères pour obtenir des réponses précises - 27 septembre 2026
- L’intelligence artificielle responsable : un cadre concret pour garder la maîtrise des décisions - 25 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Clé USB non reconnue, fichiers illisibles, formatage proposé : comment récupérer vos données sans aggraver la panne ?
 Cloud Computing : transformer votre infrastructure IT en moteur de croissance stratégique
 Checklist de sécurité des données : 5 piliers pour verrouiller votre infrastructure
 La sécurité des données protège les accès utiles sans multiplier les fuites