Moving to cloud computing : migrer vite ou moderniser en profondeur ?
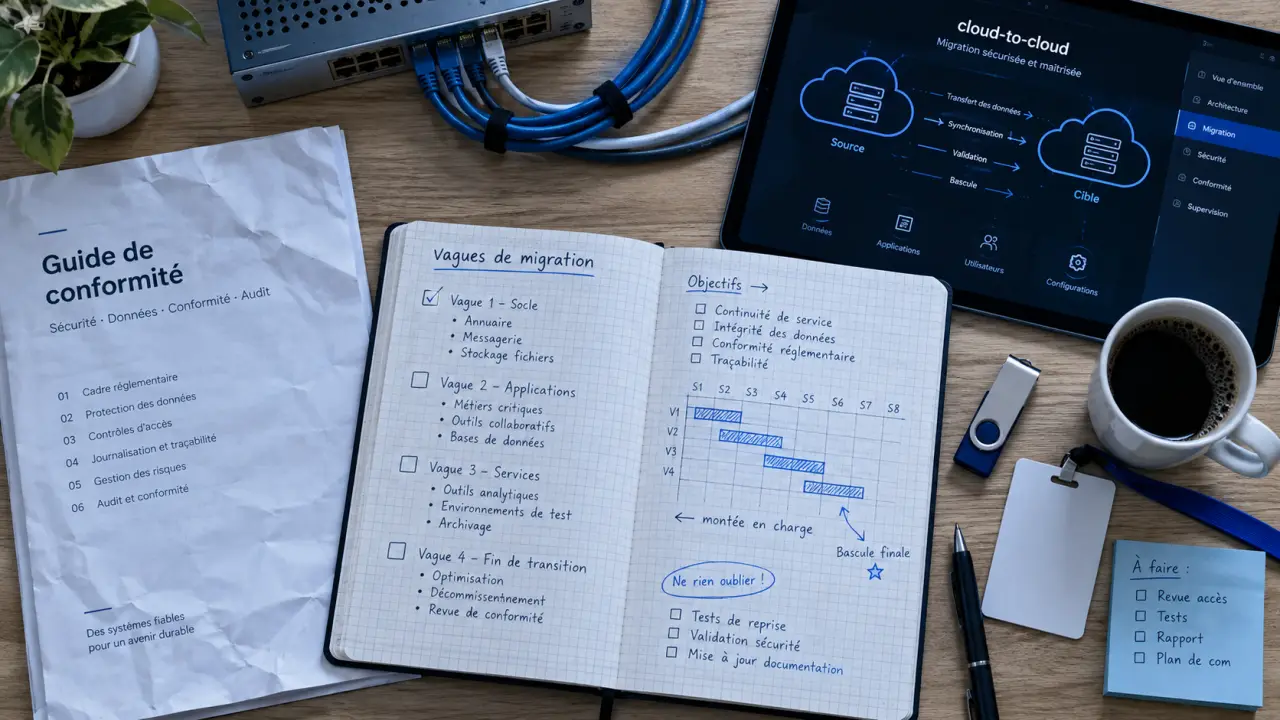
Passer au cloud ne consiste pas à déplacer des serveurs vers une nouvelle adresse. Une démarche de moving to cloud computing transforme la façon dont l’entreprise héberge ses applications, exploite ses données, pilote ses coûts et protège ses services. Bien préparée, elle apporte davantage de souplesse et de résilience. Improvisée, elle risque surtout de déplacer les mêmes contraintes dans un environnement plus difficile à maîtriser.
Ce que recouvre réellement une migration vers le cloud
La migration vers le cloud désigne le transfert total ou partiel de charges de travail depuis un centre de données sur site vers un cloud public, un environnement hybride ou un autre fournisseur cloud. Les actifs concernés sont variés : machines virtuelles, applications métier, bases de données, espaces de stockage, outils CRM, environnements de développement et flux d’intégration.
Quiz : réussir sa migration vers le cloud
Le projet ne se limite donc pas aux données. Il comprend aussi l’architecture réseau, les identités et les droits d’accès, la supervision, les sauvegardes, les dépendances entre applications et les exigences réglementaires. Une migration cloud-to-cloud, par exemple, répond souvent à un besoin de nouvelles fonctionnalités, de rapprochement géographique des données ou de réduction de l’enfermement propriétaire.
Cloud public, hybride ou services managés
Le cloud public fournit des ressources de calcul, de stockage et de réseau à la demande. L’hybride conserve une partie du système d’information sur site tout en connectant des services cloud. Cette option est pertinente lorsqu’une application sensible, un équipement industriel ou une contrainte de résidence des données impose de maintenir certains composants localement.
Les services PaaS et SaaS délèguent davantage l’exploitation technique. Ils peuvent simplifier les opérations et réduire la maintenance d’une partie de l’infrastructure, à condition d’accepter leurs règles d’intégration et de configuration. Le choix du modèle dépend donc des contraintes de l’entreprise, du niveau de contrôle recherché et de la transformation envisagée.
Les bénéfices attendus, et les compromis à assumer
Le premier intérêt du cloud est de remplacer une partie des dépenses d’investissement, ou CapEx, par des dépenses d’exploitation, ou OpEx. L’entreprise évite d’acheter et de renouveler elle-même une partie du matériel. Elle peut aussi ajuster les ressources à l’activité, accélérer la mise à disposition d’environnements et accéder à des services managés utiles pour l’analyse de données, l’automatisation ou le machine learning.
La définition officielle du cloud computing selon le NIST · Ce document de référence présente les cinq caractéristiques essentielles du cloud, ses trois modèles de services et ses quatre modèles de déploiement.
Cette souplesse ne signifie pas que la facture diminue automatiquement. Les ressources doivent être dimensionnées et suivies avec précision. Une capacité inutilisée, une instance conservée après un test ou un service mal configuré peut augmenter les dépenses. Le bénéfice financier dépend donc de la visibilité sur les usages et d’un pilotage régulier.
La performance, la disponibilité et la reprise après incident peuvent progresser si l’architecture est conçue pour cela. Elles ne sont toutefois pas garanties par le simple choix d’un fournisseur. Une application monolithique déplacée telle quelle peut rester lente, coûteuse ou fragile. De même, le modèle de responsabilité partagée implique que le fournisseur sécurise l’infrastructure cloud, tandis que le client reste responsable de ses configurations, de ses accès, de ses données et de ses usages.
Le noyau du projet : les dépendances invisibles
Dans une migration, le noyau n’est pas forcément l’application la plus visible : ce sont souvent ses dépendances. Un serveur peut sembler simple à déplacer, mais il dialogue parfois avec un annuaire, un partage de fichiers, une imprimante, une base historique, un flux batch nocturne ou une adresse IP autorisée chez un partenaire.
Cartographier ces liaisons avant toute vague évite les coupures silencieuses. Cette lecture du système d’information aide aussi à regrouper les composants qui doivent migrer ensemble et à isoler ceux qui méritent d’être modernisés ou retirés. Elle permet enfin d’identifier les applications dont le fonctionnement repose sur des éléments anciens, peu documentés ou difficiles à reproduire dans le cloud.
Six stratégies pour ne pas traiter toutes les applications de la même façon
Il n’existe pas de stratégie universelle. La bonne décision dépend de la criticité métier, de l’obsolescence, du délai acceptable, des compétences disponibles et du niveau de transformation recherché. Un portefeuille applicatif combine généralement plusieurs approches, selon la situation de chaque application.
| Stratégie | Principe | Quand la privilégier |
|---|---|---|
| Réhébergement | Déplacer l’application presque à l’identique, ou lift and shift. | Pour sortir vite d’une infrastructure vieillissante ou réduire un risque immédiat. |
| Replatforming | Adapter quelques composants à des services cloud managés. | Quand un gain opérationnel est possible sans réécriture complète. |
| Refactorisation | Repenser le code et l’architecture pour le cloud. | Pour une application stratégique qui doit gagner en agilité, en résilience ou en capacité d’évolution. |
| Rachat | Remplacer le logiciel existant par une solution SaaS. | Quand la fonction est standard et qu’un produit du marché répond au besoin. |
| Retrait | Mettre hors service un actif devenu inutile. | Lorsque l’audit révèle des applications redondantes, peu utilisées ou sans propriétaire. |
| Retenir | Conserver temporairement l’actif dans son environnement actuel. | Si les contraintes techniques, réglementaires ou contractuelles ne sont pas levées. |
Le réhébergement réduit l’effort initial, mais ne corrige pas les défauts structurels. La refactorisation offre un potentiel de modernisation plus élevé, au prix d’un effort, de tests et d’une conduite du changement plus importants. Entre les deux, le replatforming constitue souvent un compromis raisonnable : une base de données ou un système de messagerie managé peut diminuer la charge d’exploitation sans remettre en cause toute l’application.
Le tableau sert de cadre de décision, pas de classement automatique. Une application stratégique peut justifier une refactorisation, tandis qu’un outil secondaire peut être réhébergé ou retiré. Le choix doit relier la stratégie technique à la valeur métier attendue, au délai disponible et aux contraintes de l’existant.
Construire une migration par vagues, sans bloquer l’activité
Une migration fiable commence par une évaluation : inventaire des actifs, mesure des usages, analyse des dépendances, qualification des données, coûts actuels et contraintes de conformité. Cette phase doit associer la DSI, les équipes infrastructure, la sécurité, la finance et les responsables métiers.
Sans propriétaire métier clairement identifié, il est difficile de valider qu’une application fonctionne réellement après son déplacement. Ce responsable aide à préciser les usages attendus, les périodes sensibles, les critères d’acceptation et les conséquences d’une interruption. L’inventaire doit aussi faire apparaître les actifs redondants, inutilisés ou dépourvus de documentation.
Préparer une architecture gouvernée dès le départ
Avant la première migration, définissez une zone d’atterrissage cloud : organisation des comptes ou abonnements, segmentation réseau, journalisation, chiffrement, sauvegardes, gestion des secrets et règles d’accès. Cette base fournit un cadre commun aux différentes vagues et limite les écarts de configuration.
L’authentification multifacteur, le principe du moindre privilège et une approche Zero Trust doivent être intégrés dès la conception. La conformité ne se vérifie pas seulement à la fin : elle se traduit dans les paramètres, les preuves d’audit et les processus de contrôle. Les équipes doivent donc savoir qui peut accéder aux données, quelles actions sont journalisées et comment les sauvegardes sont restaurées.
Tester, migrer, valider, puis apprendre
Commencez par une vague pilote composée d’applications représentatives mais maîtrisables. Testez les performances, les restaurations, les droits d’accès, les interfaces et les scénarios de retour arrière. Après validation métier, industrialisez les vagues suivantes en réutilisant les procédures qui ont fonctionné.
Chaque vague doit préciser son périmètre, ses dépendances, sa fenêtre d’intervention, ses critères de réussite et son plan de retour arrière. Cette discipline réduit le risque de découvrir une contrainte au moment du basculement. Un abandon complet de centre de données peut demander 1 an ou plus de planification : cette durée justifie un pilotage progressif plutôt qu’un basculement massif.
Après le basculement : maîtriser les coûts et éviter le vendor lock-in
La migration n’est pas la fin du projet. Une ressource surdimensionnée, allumée en permanence ou oubliée après un test peut rapidement dégrader le budget. Une démarche FinOps rapproche les équipes techniques, les métiers et la finance pour rendre les dépenses visibles, attribuables et ajustables.
Il faut suivre les consommations, supprimer les ressources inutilisées, choisir les capacités adaptées et arbitrer régulièrement entre performance et coût. La gouvernance doit rester active après le basculement, car les usages et les besoins évoluent. Les règles définies au lancement doivent être contrôlées dans la durée.
Préservez également la réversibilité. Documentez les formats de données, les interfaces, les mécanismes d’export et les engagements contractuels. Utiliser des services propriétaires peut être pertinent lorsqu’ils apportent un vrai avantage, mais ce choix doit être conscient. La documentation des dépendances limite la difficulté d’un changement ultérieur de fournisseur ou d’architecture.
Un partenaire spécialisé ou les outils du fournisseur peuvent accélérer l’audit et l’exécution. Ils ne remplacent ni la gouvernance interne ni les décisions d’architecture. Une migration réussie est celle qui rend le système d’information plus exploitable, plus contrôlable et mieux adapté aux besoins de l’entreprise, pas seulement hébergé ailleurs.
Partager cet article
Articles qui pourraient vous intéresser :
 Clé USB non reconnue, fichiers illisibles, formatage proposé : comment récupérer vos données sans aggraver la panne ?
 Biais dans l’intelligence artificielle : données, modèles, usages, les trois angles morts à surveiller
 DeepSeek jailbreak : 58 % d’échecs aux tests, quelles défenses prioriser ?
 L’intelligence artificielle responsable : un cadre concret pour garder la maîtrise des décisions